Recherche · mémoire récurrente · Sovra vNext

NC01 — Native Consolidation : protection temporaire des lectures dans une mémoire récurrente

Comment conserver une association sélectionnée dans l’état d’un LLM hybride, malgré les mises à jour ultérieures de sa mémoire.

Résumé

NC01 — Native Consolidation — est un programme de recherche consacré à la conservation d’associations sélectionnées dans la mémoire récurrente d’une architecture de langage hybride. Le problème étudié consiste à incorporer une information récupérée dans l’historique, puis à préserver sa lecture pendant un horizon défini, malgré les mises à jour ultérieures de l’état.

La construction présentée repose sur une factorisation de la mémoire en une composante réalisant les lectures protégées et un complément orthogonal évolutif. Les écritures sont projetées dans les directions compatibles avec les engagements actifs. Une compensation ajuste la transition récurrente, tandis qu’une garde contrôle la norme de l’état. Le lecteur demeure celui de la mémoire native.

La réalisation étudiée, CP64 v2, dispose d’une transition en forme close et d’une formulation par segments. Une campagne réservée après gel du code a exécuté 172 032 transitions, sans dépassement observé du seuil de rétention. Des vérifications complémentaires comprennent 24 576 transitions de stress géométrique, des comparaisons CPU/GPU et un parcours de 1 050 624 transitions depuis des états initialement nuls.

La revue technique confirme le principe de conservation en arithmétique exacte et sa réalisation sur les parcours testés. Elle identifie également des défauts numériques d’admission, des points d’interface et des insuffisances de mesure qui empêchent de conclure à une validation complète de l’implémentation. Les résultats portent sur le mécanisme de mémoire ; son utilité dans un LLM entraîné reste à mesurer.

Mots-clés

  • mémoire récurrente
  • LLM
  • consolidation native
  • mémoire associative
  • interférence
  • rétention
  • architectures hybrides
1

Problème étudié

Les architectures hybrides combinant attention et récurrence disposent de deux modes de représentation du passé.

L’attention peut consulter des représentations historiques conservées au niveau des positions de la séquence. La récurrence maintient un état compact, actualisé à chaque nouvelle entrée. La taille de cet état peut rester constante lorsque la séquence s’allonge.

Cette compression introduit un problème d’interférence : une mise à jour destinée à intégrer une nouvelle association peut modifier les réponses produites pour des adresses antérieures. Le mécanisme de lecture reste inchangé, mais la fonction réalisée par la mémoire évolue.

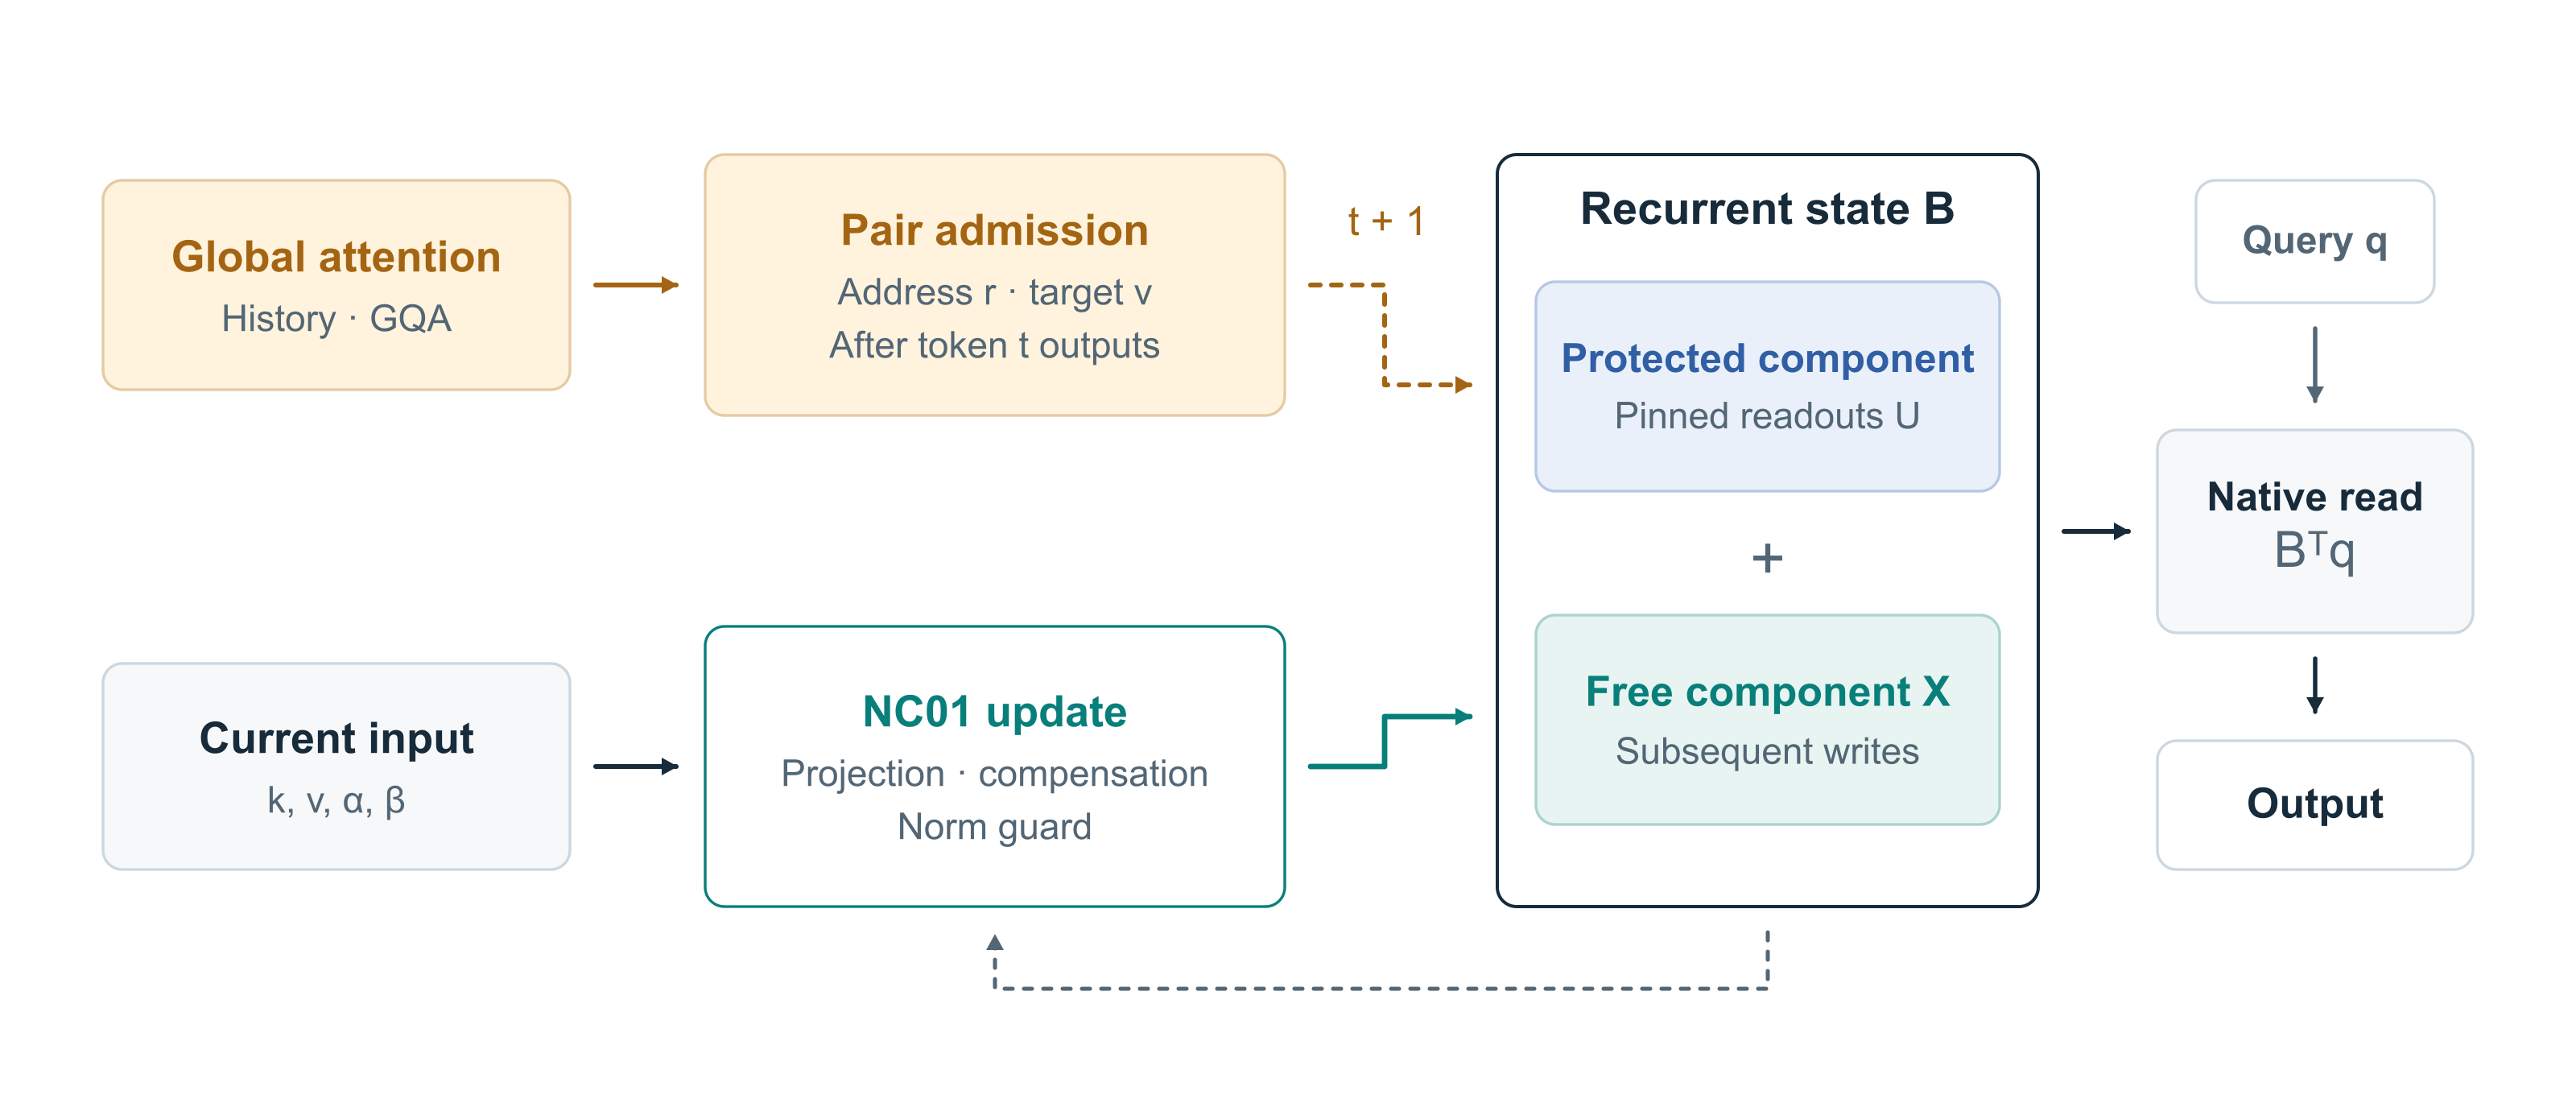
NC01 étudie le cas où une association historique peut être récupérée, proposée à la mémoire récurrente et admise comme engagement temporaire. La question est alors de construire une transition qui permette simultanément :

  1. la conservation des lectures associées aux engagements actifs ;
  2. la poursuite des mises à jour dans les directions disponibles ;
  3. le maintien d’un état de norme bornée ;
  4. une réalisation causale avec des ressources indépendantes de la longueur de la séquence, à configuration fixée.
Lorsqu’une nouvelle écriture entre en conflit avec un engagement vivant, la lecture protégée est prioritaire.

Le programme a été développé dans le cadre de Sovra vNext. La construction examinée dans cet article est CP64-v2.0, une réalisation particulière de NC01 fondée sur des lectures épinglées. Elle adopte un compromis explicite : lorsqu’une nouvelle écriture entre en conflit avec un engagement vivant, la lecture protégée est prioritaire.

Cet article détaille le mécanisme et les expériences. Pour une introduction plus courte au principe de NC01 et à son rôle dans Sovra, voir notre premier article sur NC01.

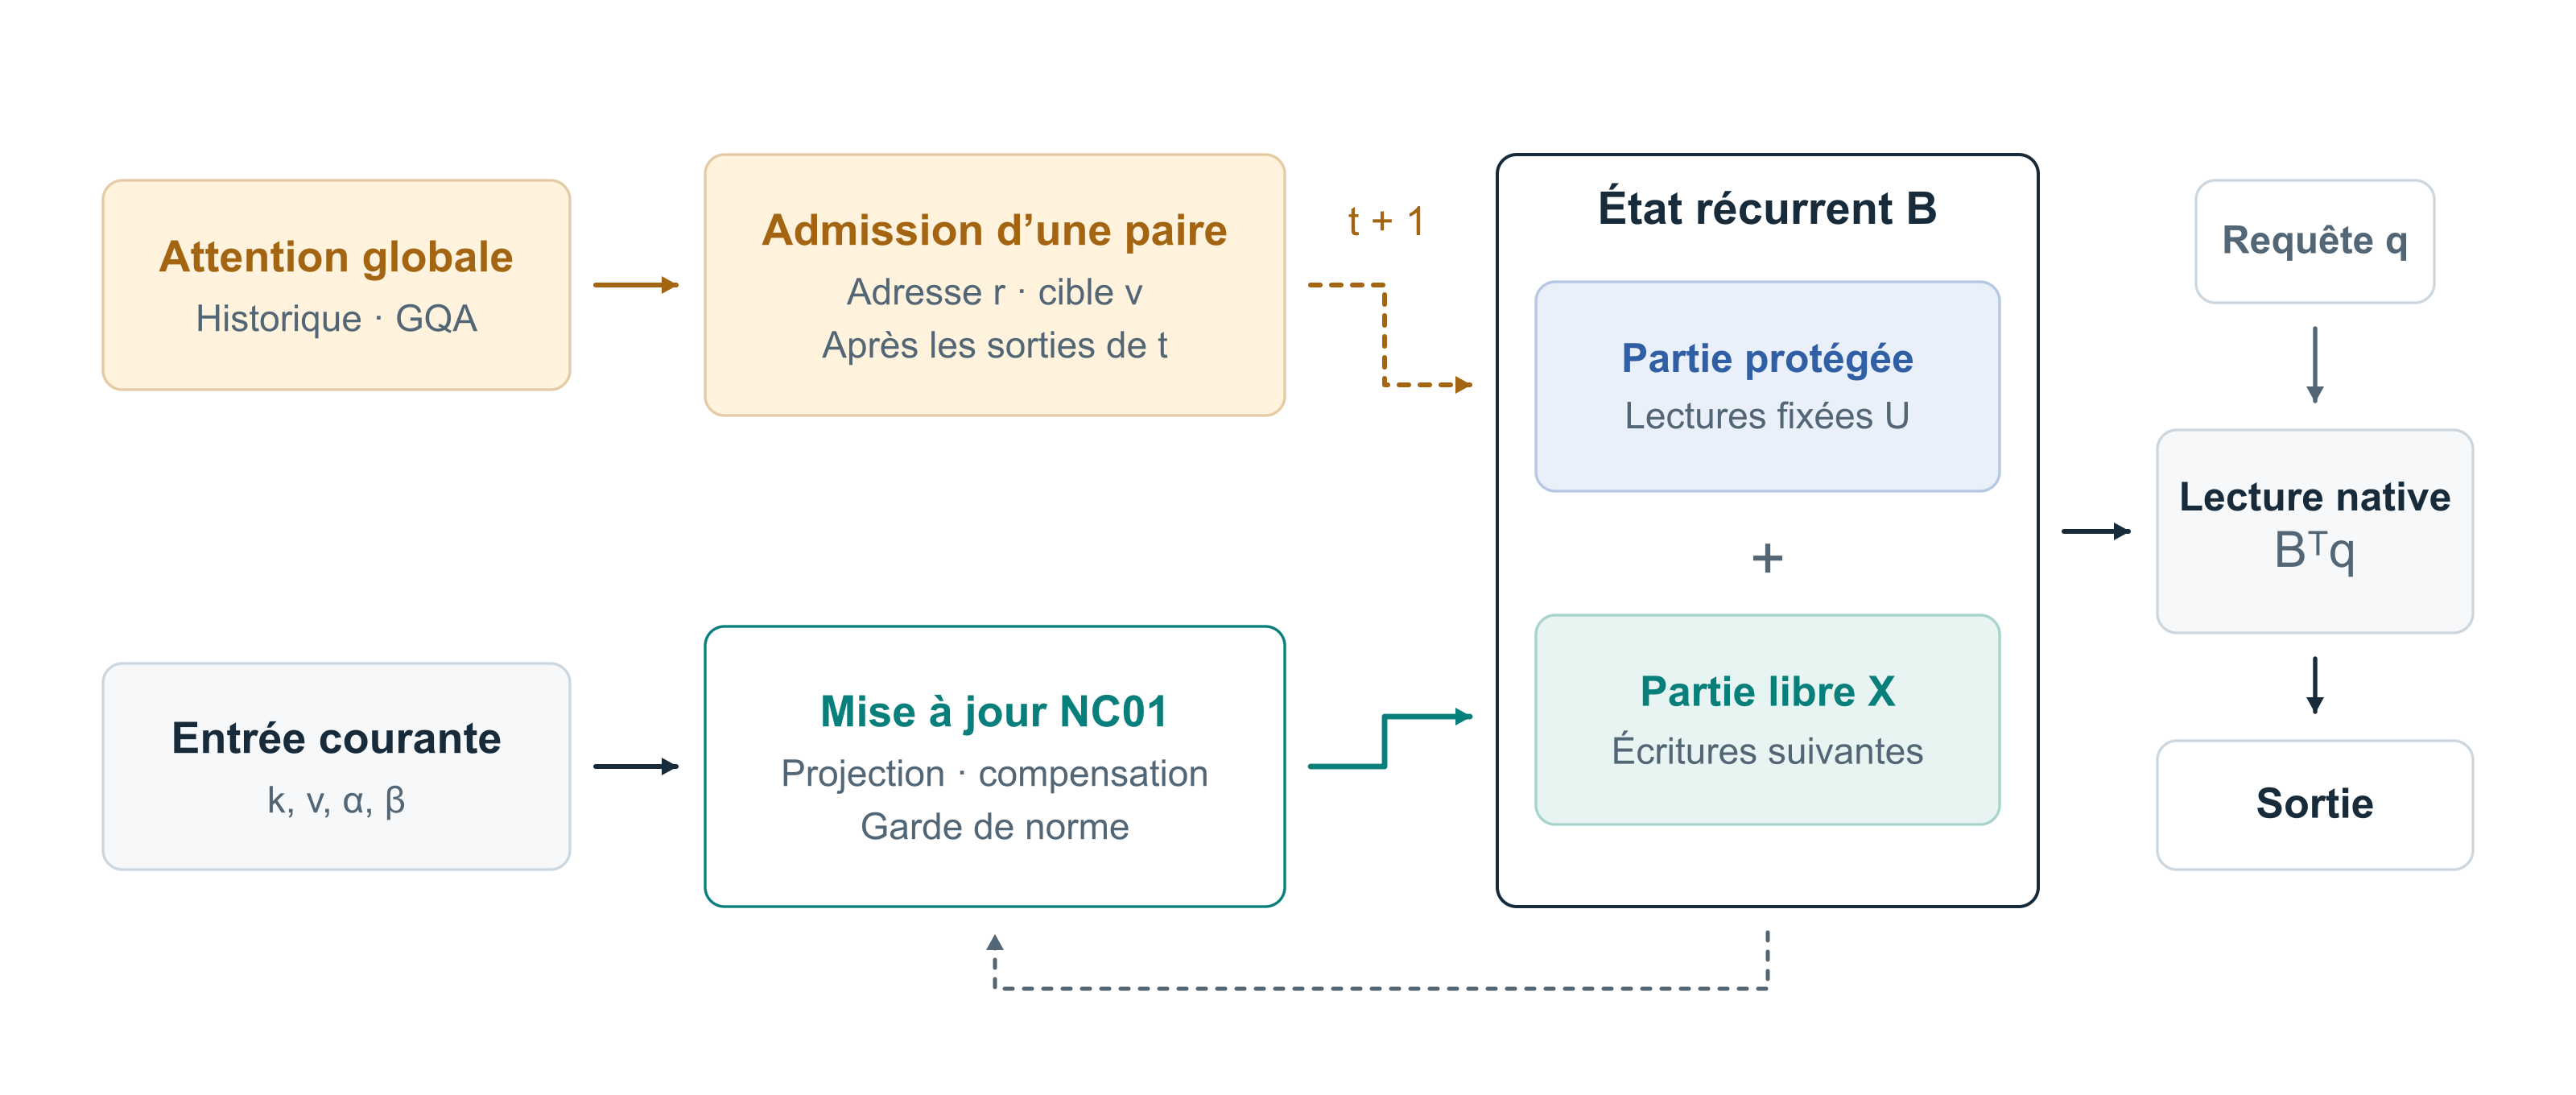
Une paire historique récupérée par l’attention est admise dans la mémoire récurrente ; les écritures suivantes actualisent la composante libre et la lecture reste native.
Du passé récupéré à la mémoire protégéeOuvrir en grand ↗
2

Positionnement par rapport aux travaux existants

Mémoires récurrentes à règle delta

DeltaNet

Les mémoires associatives récurrentes utilisent des règles d’écriture pour modifier un état matriciel. Les travaux sur Gated DeltaNet associent notamment une règle delta, permettant des mises à jour ciblées, à des portes contrôlant la conservation de l’état.

Titans explore également l’articulation entre attention et mémoire neuronale actualisée pendant le traitement. Ces travaux établissent un contexte architectural dans lequel la mémoire compacte constitue un composant actif du calcul.
Contraintes temporaires sur les lectures

NC01

NC01 examine plus spécifiquement la possibilité d’imposer des contraintes temporaires sur certaines lectures de cette mémoire.

Les outils mathématiques mobilisés — projection orthogonale, factorisation matricielle et optimisation quadratique sous contraintes — sont classiques. La contribution étudiée concerne leur combinaison avec une transition récurrente, une admission causale et un cycle de vie borné des engagements.

Cette problématique se distingue de la récupération documentaire externe. Le Retrieval-Augmented Generation fournit un accès à une mémoire non paramétrique, par exemple un index de documents. NC01 agit sur l’état récurrent utilisé pendant le calcul. Une récupération externe ou attentionnelle peut fournir une association candidate, mais sa conservation est ensuite réalisée dans la mémoire native.

3

Formalisation de la mémoire et des engagements

3.1État et lecteur natifs

Une banque mémoire est représentée par une matrice :

\[B\in\mathbb{R}^{d_k\times d_v}.\]

Pour une requête \(q\in\mathbb{R}^{d_k}\), le lecteur produit :

\[\operatorname{Read}(B,q)=B^\top q.\]

La transition native de référence appartient à une famille de règles delta avec portes :

\[F_0(B;k,v,\alpha,\beta)=\alpha(I-\beta kk^\top)B+\beta kv^\top.\]

La clé \(k\) définit la direction de l’écriture, \(v\) sa valeur, \(\alpha\) le facteur de conservation et \(\beta\) l’intensité de la mise à jour.

Dans le domaine étudié, les clés et les valeurs sont bornées en norme, avec \(0\leq\beta\leq1\) et \(0\leq\alpha<1\).

3.2Engager une lecture

Un engagement associe une adresse \(r_j\) à une cible historique \(v_j\). À l’admission, le mécanisme établit une valeur épinglée \(u_j\), proche de cette cible.

Cette distinction est importante : la conservation porte sur \(u_j\), tandis que l’erreur d’acquisition est mesurée entre \(u_j\) et \(v_j\).

Pour \(m\) engagements actifs, on définit :

\[K=[r_1,\ldots,r_m],\qquad U=\begin{bmatrix}u_1^\top\\ \vdots\\ u_m^\top\end{bmatrix},\qquad H=K^\top K.\]

Le conditionnement de \(H\) contrôle la compatibilité géométrique des adresses. La configuration étudiée impose nominalement :

\[H\succeq \frac14 I.\]

Les adresses protégées ne peuvent donc pas être arbitrairement redondantes.

3.3Décomposition de l’état

La mémoire est représentée sous la forme :

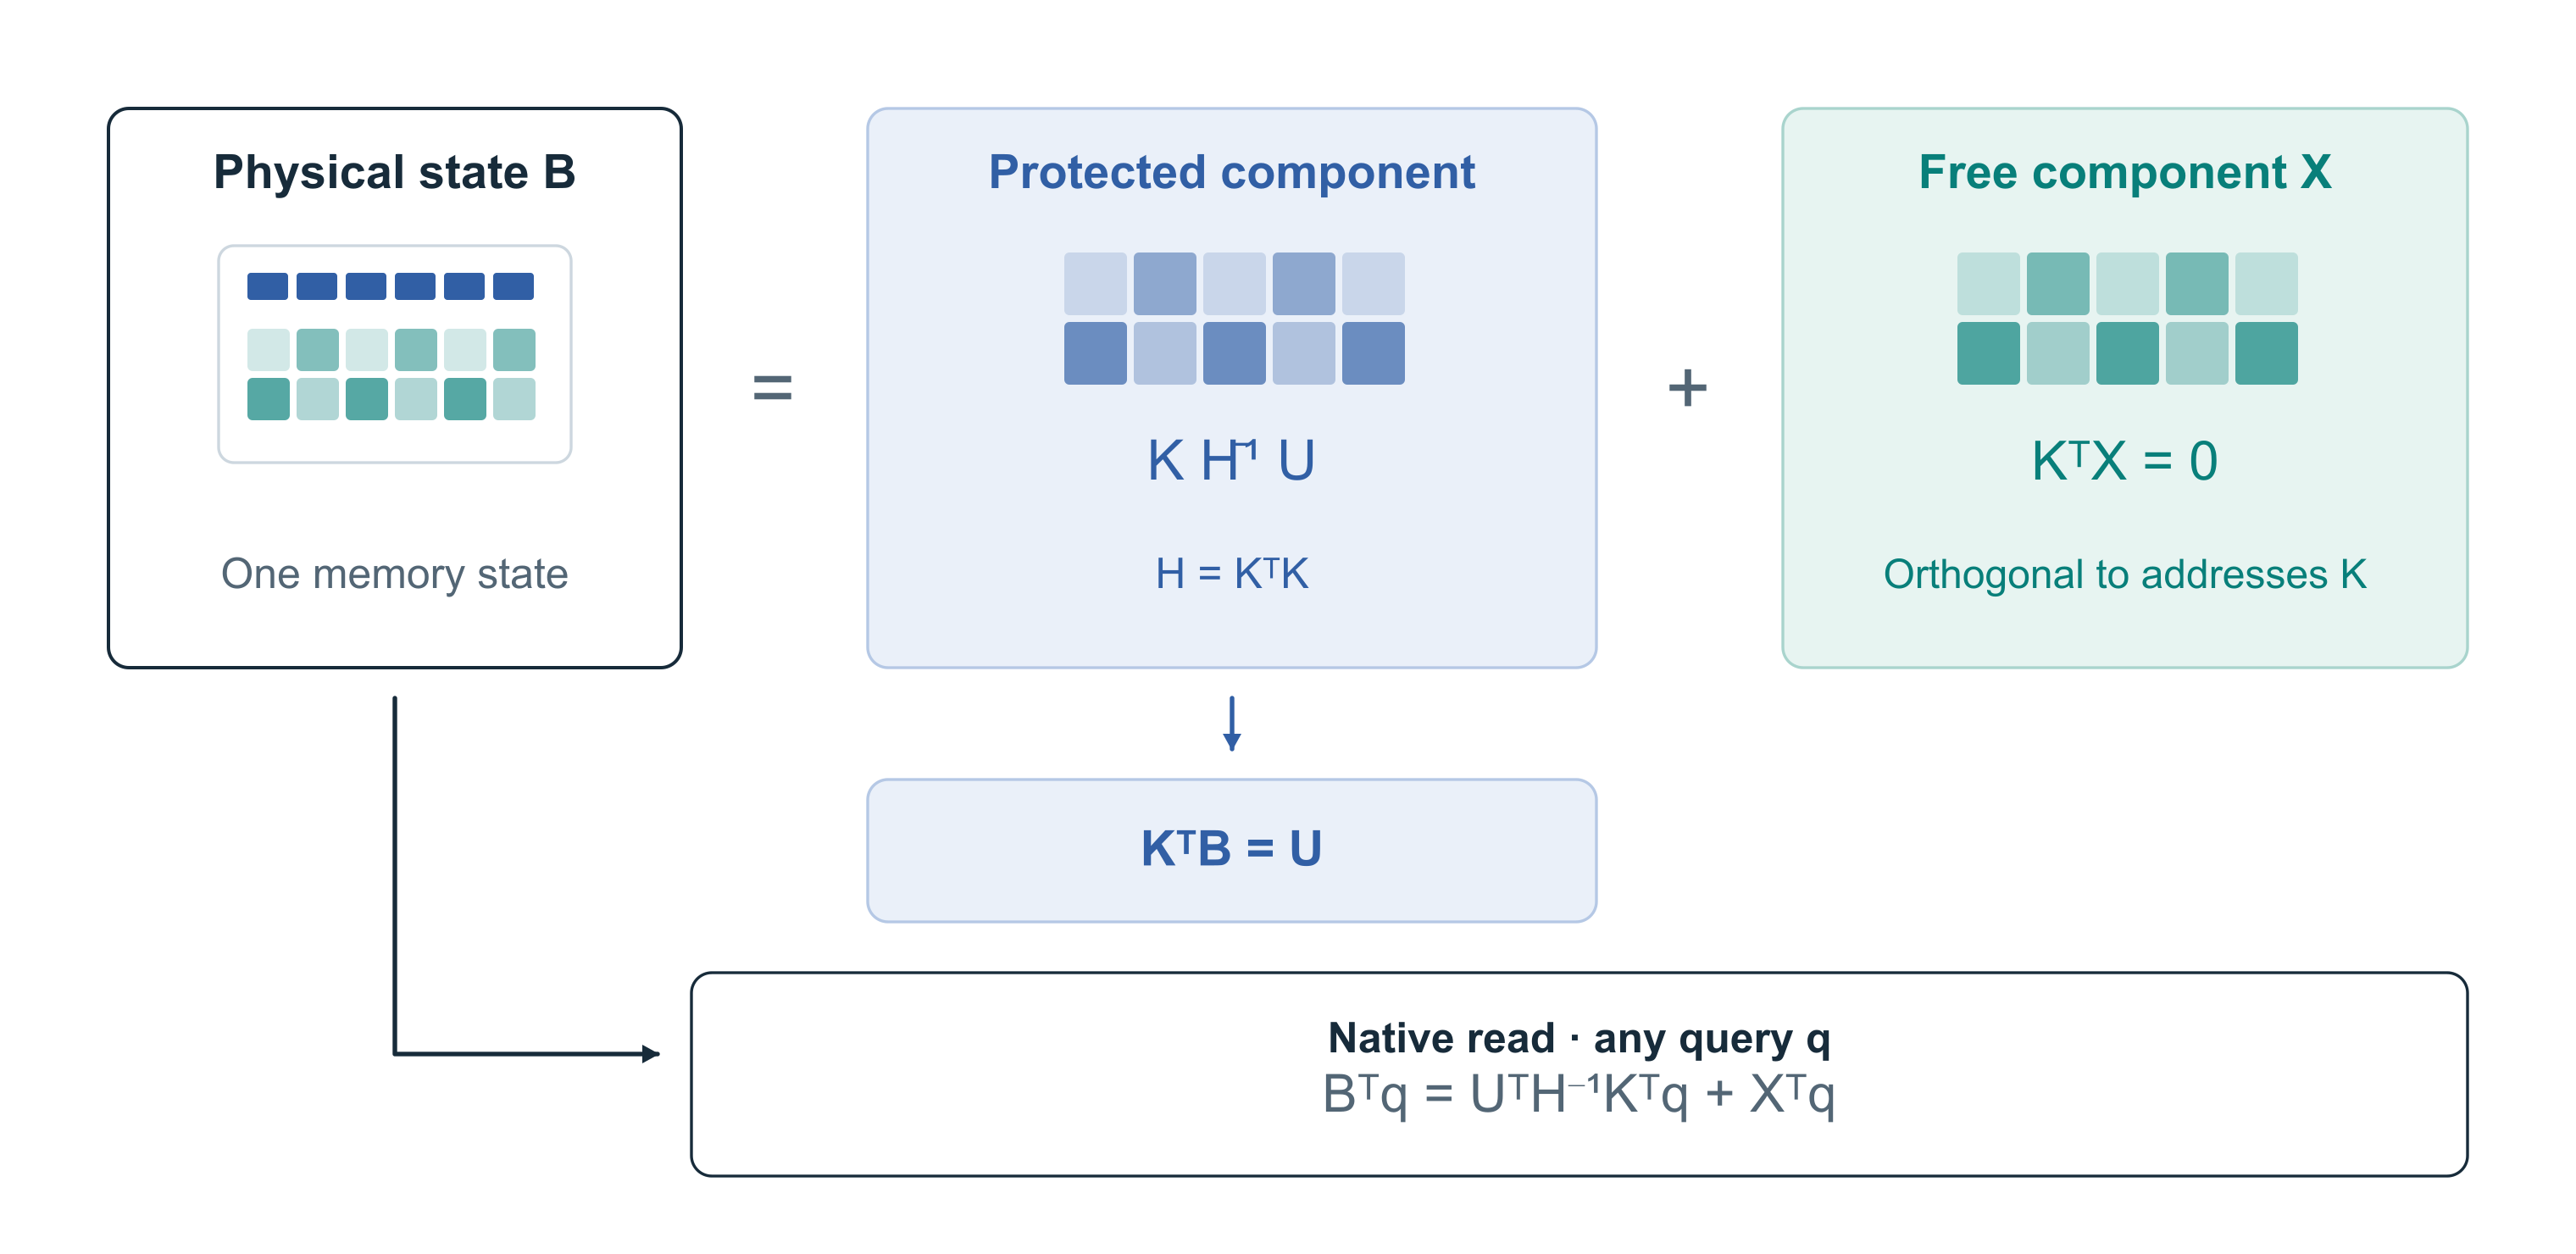
\[\boxed{B=KH^{-1}U+X},\qquad K^\top X=0.\]

La première composante réalise les lectures épinglées. Le complément \(X\) contient les degrés de liberté orthogonaux aux adresses protégées.

Il en résulte :

\[K^\top B=K^\top KH^{-1}U+K^\top X=U.\]

Cette identité constitue l’invariant central de la construction.

Le lecteur factorisé reste équivalent à celui de la matrice physique :

\[B^\top q=U^\top H^{-1}K^\top q+X^\top q.\]

Les deux termes contribuent à une seule application linéaire. La factorisation ne crée pas un second lecteur chargé de consulter les cibles historiques.

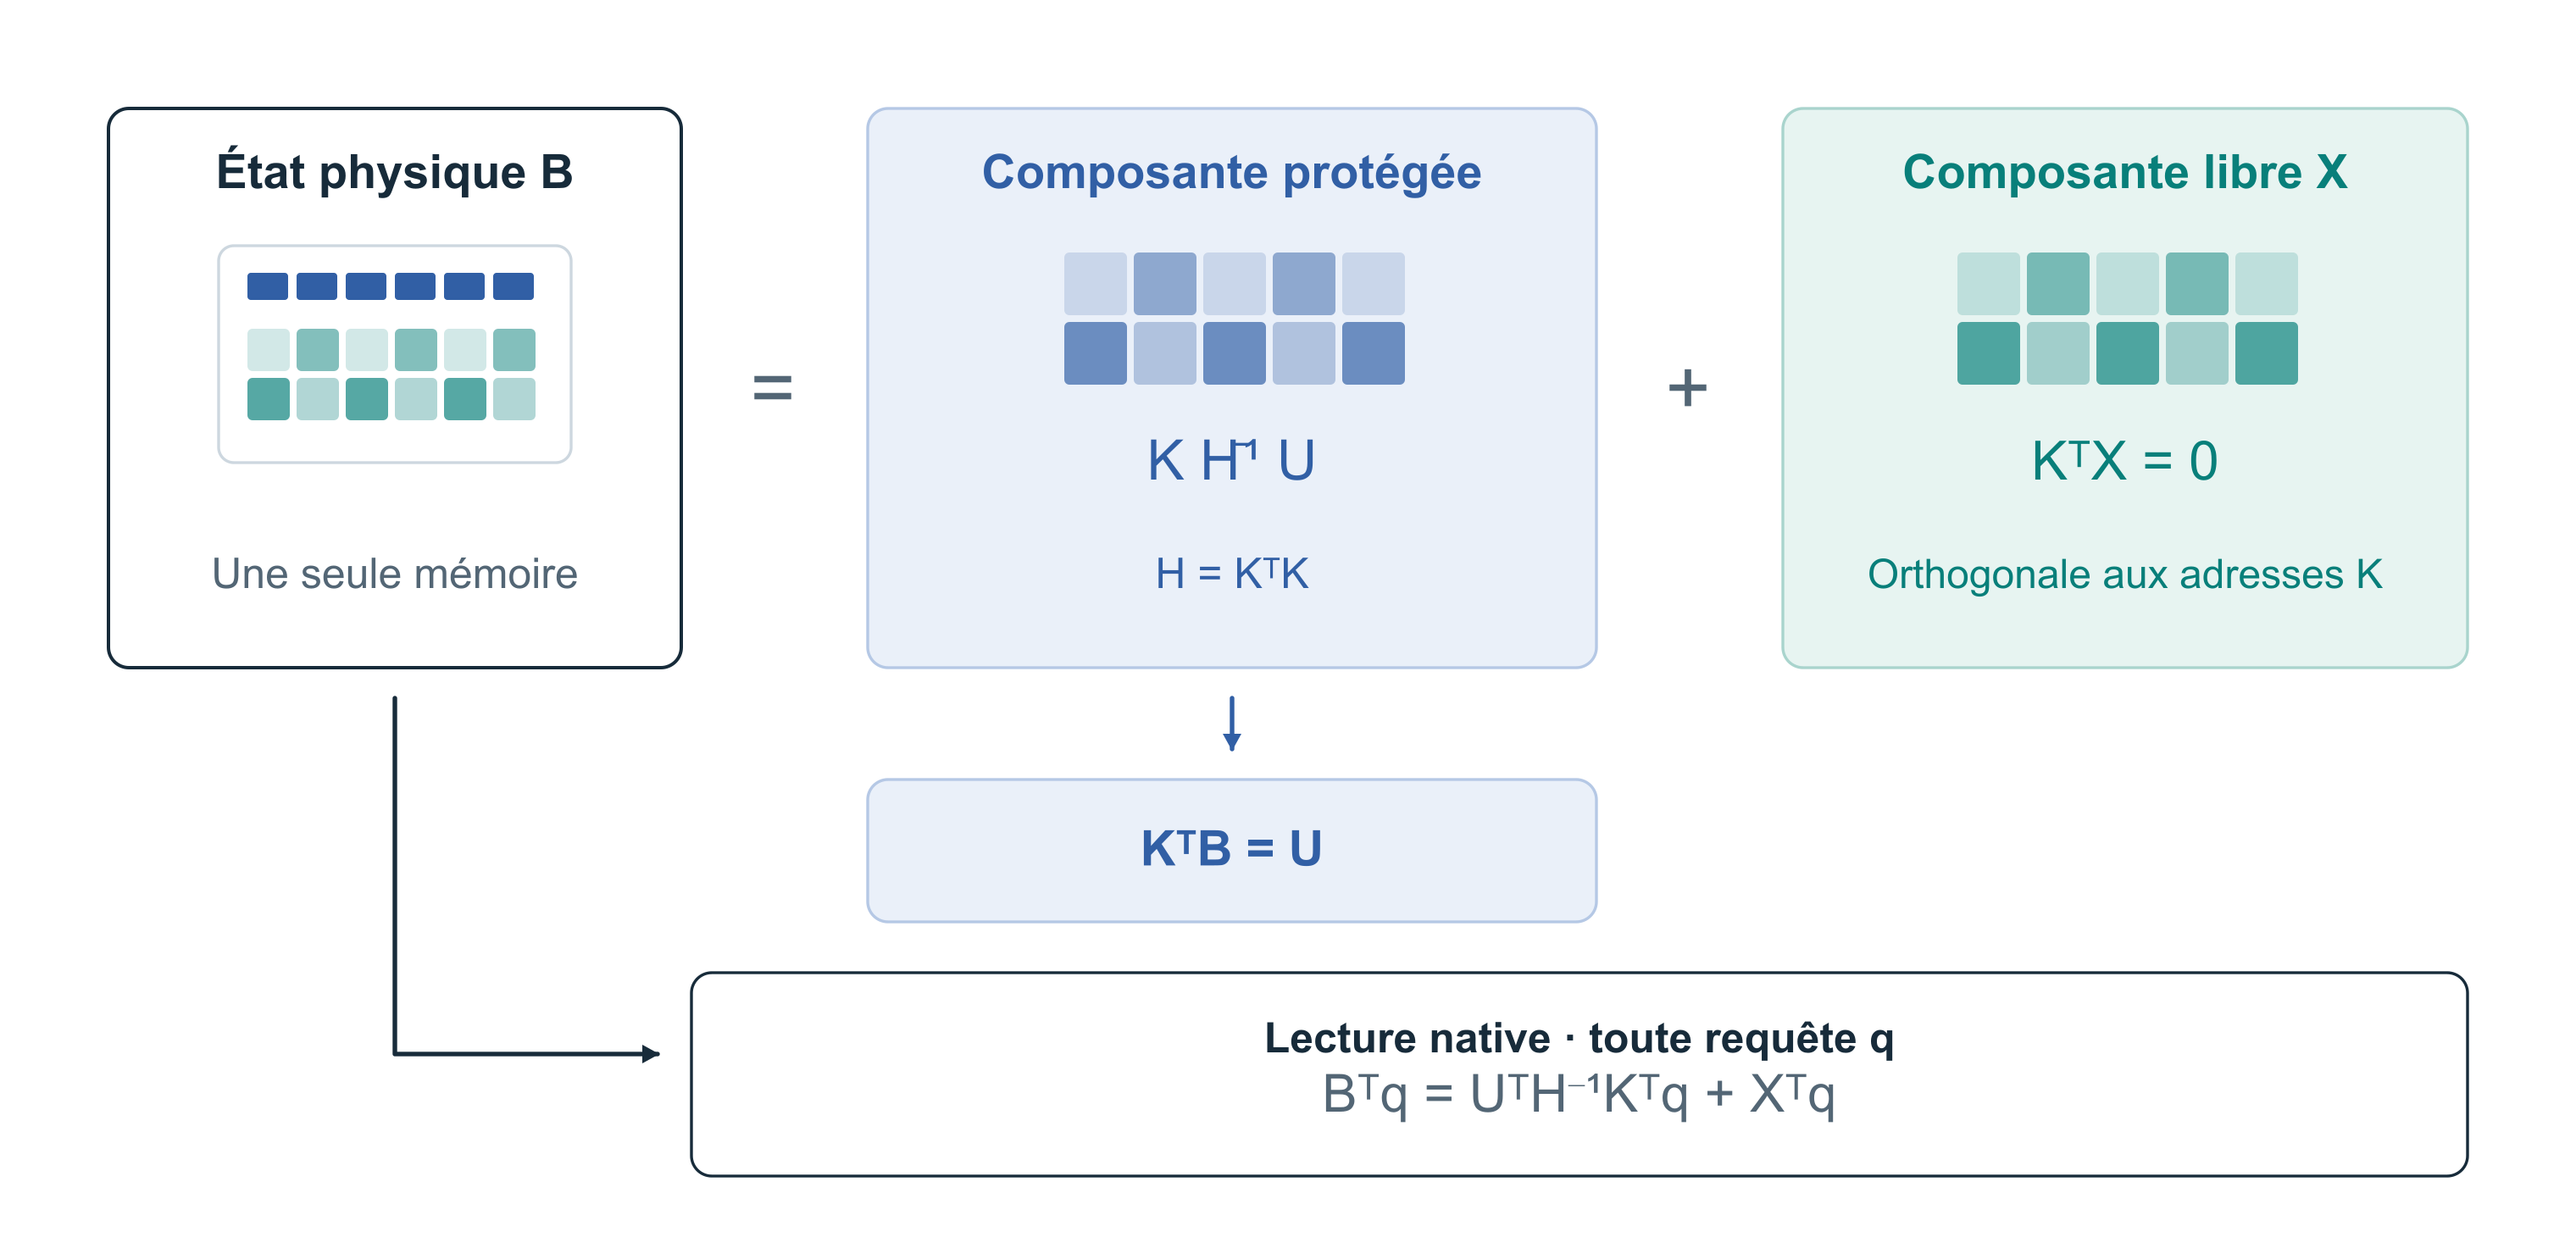
Décomposition de l’état B en composante protégée et complément orthogonal X, avec conservation des lectures U et identité du lecteur Bᵀq.
Décomposition de l’état : lectures protégées et complément libreOuvrir en grand ↗
4

Construction de la transition protégée

4.1Projection de la clé d’écriture

Le projecteur sur le sous-espace des adresses protégées est :

\[P_K=KH^{-1}K^\top.\]

La composante libre d’une nouvelle clé est :

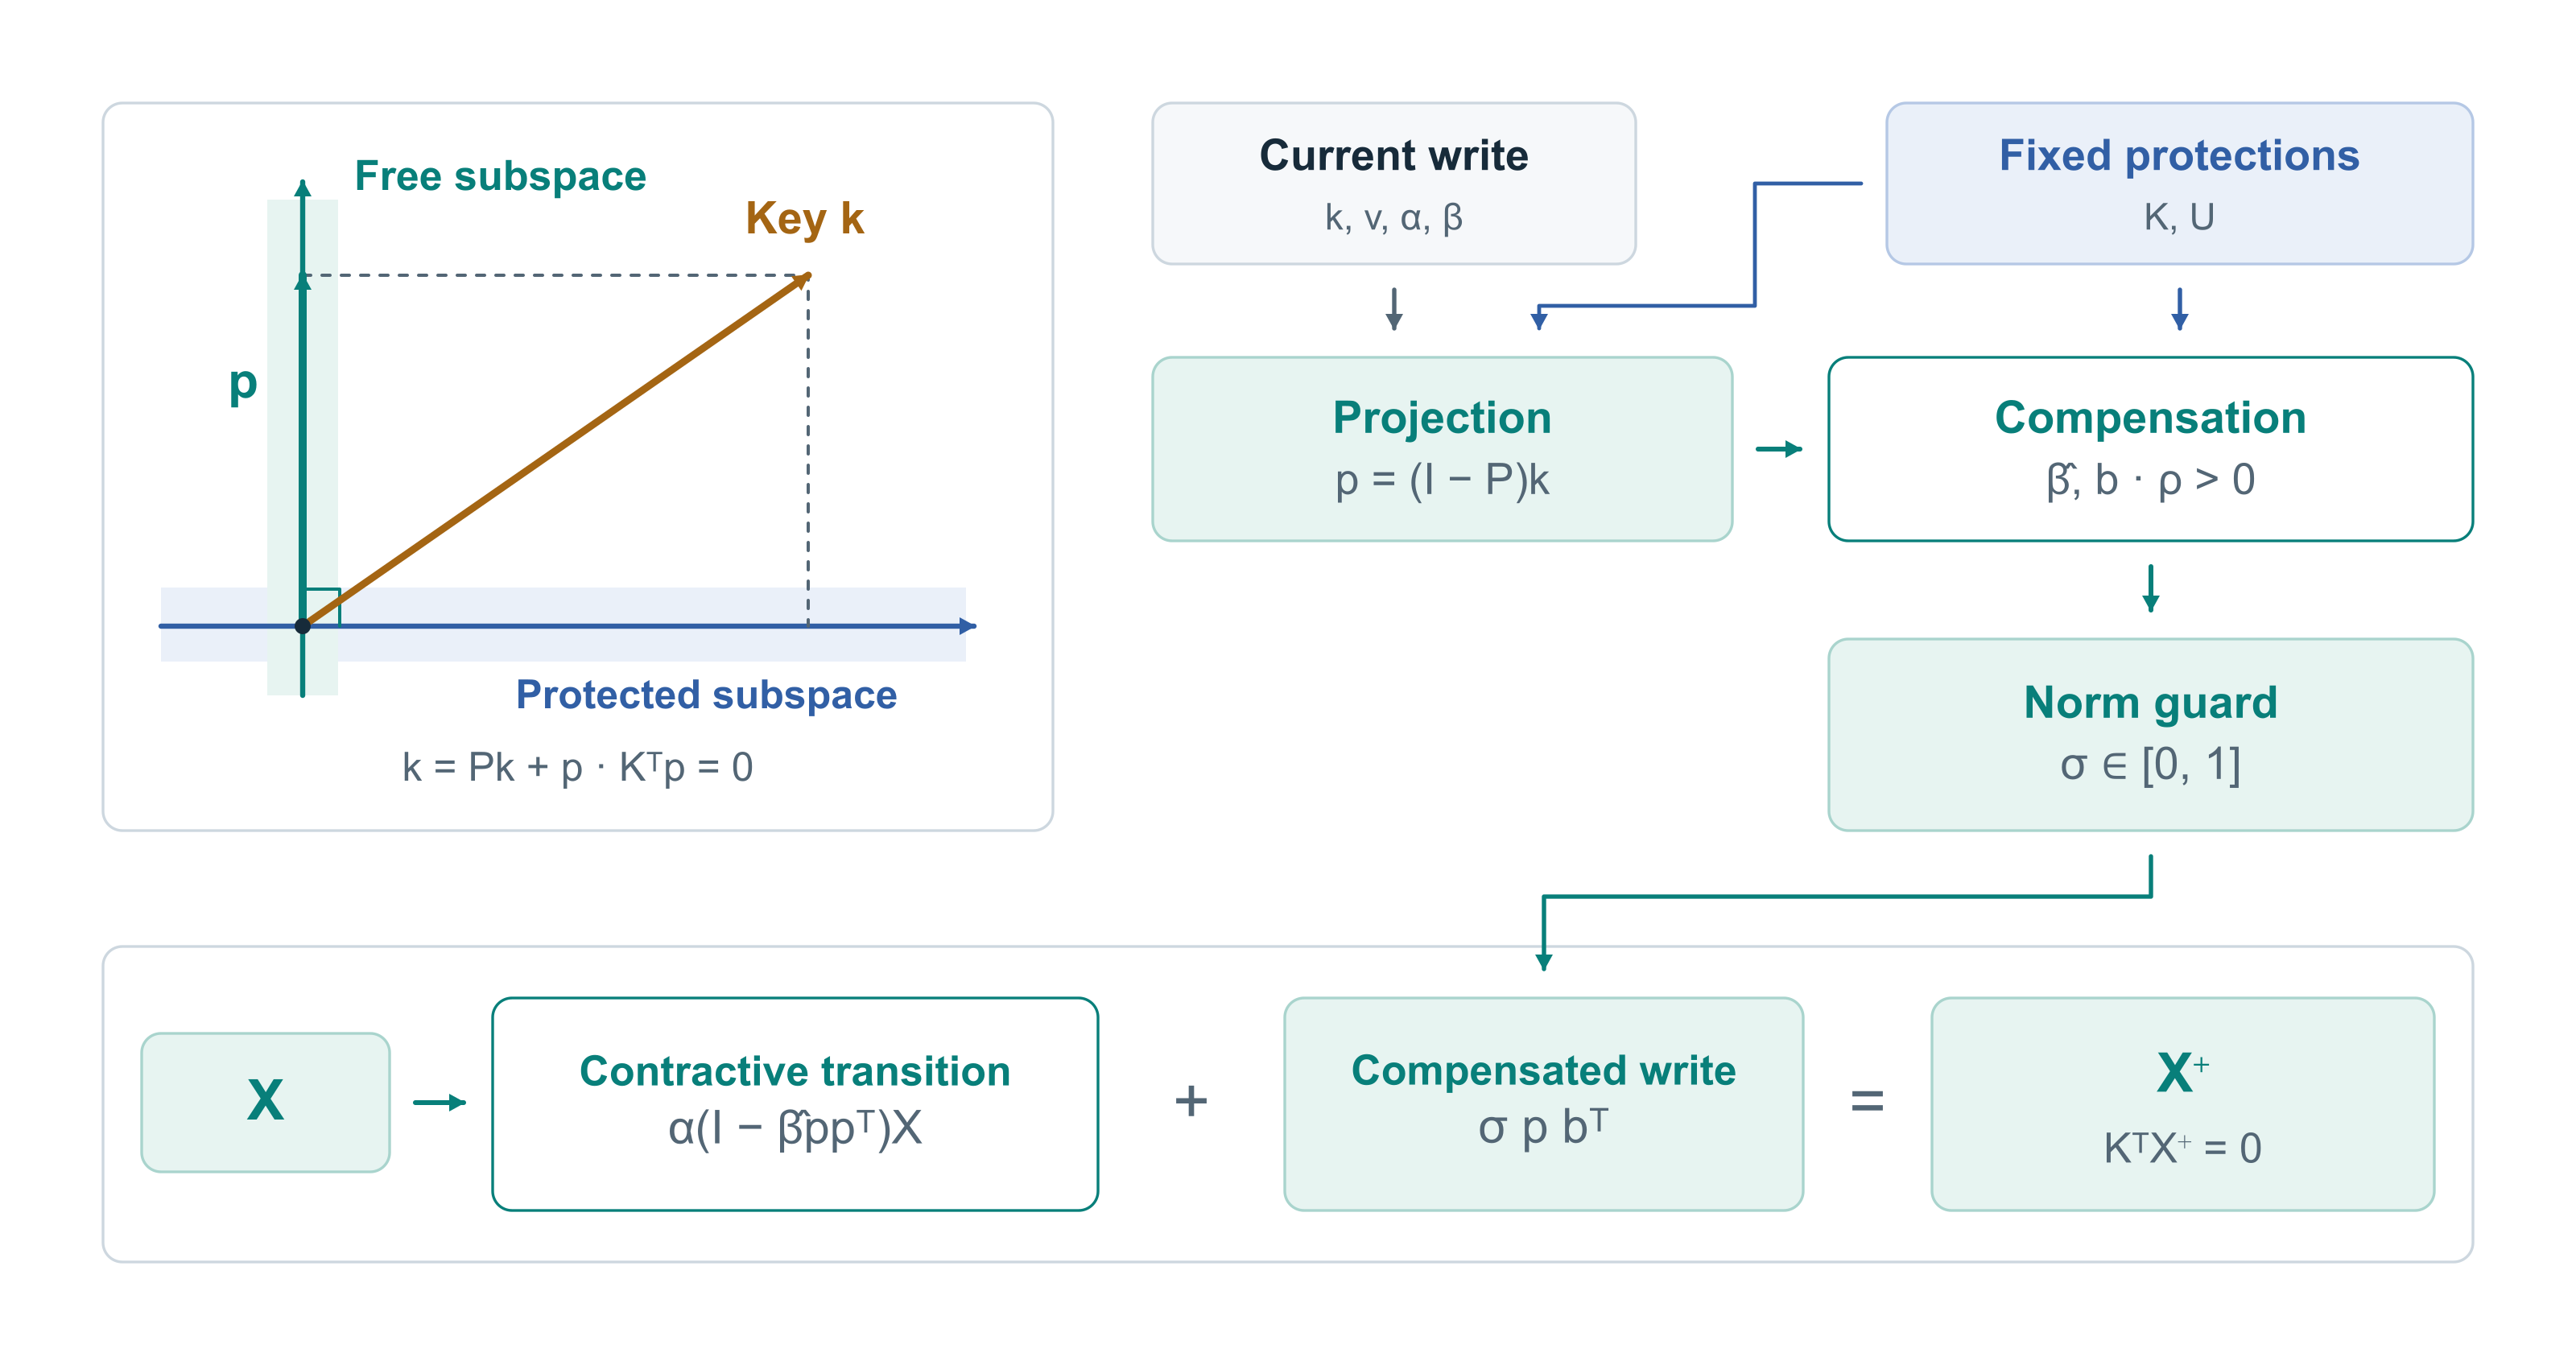
\[p=(I-P_K)k.\]

Elle vérifie :

\[K^\top p=0.\]

Une correction portée par \(p\) peut donc modifier le complément sans déplacer les lectures épinglées, sous réserve que l’orthogonalité soit effectivement maintenue.

4.2Compensation de la transition

La projection est complétée par un ajustement des coefficients d’écriture et de récurrence.

À engagements fixés, la transition s’écrit :

\[X^+=\alpha(I-\widehat{\beta}pp^\top)X+\sigma p b^\top.\]

Les coefficients sont définis par :

\[c=H^{-1}K^\top k,\qquad y=U^\top c,\]
\[\tau^2=\|p\|^2,\qquad \pi^2=\|P_Kk\|^2,\qquad g=\frac{1}{\tau^2+\rho},\]
\[\widehat{\beta}=\beta(1+\pi^2g),\]
\[b=\widehat{\beta}v-\left[\alpha\beta+(1-\alpha+\alpha\beta\pi^2)g\right]y.\]

Le paramètre \(\rho>0\) règle le compromis de compensation. Sa présence évite une division singulière lorsque la composante libre de la clé tend vers zéro.

Le facteur \(\sigma\in[0,1]\) correspond à la garde de norme.

4.3Interprétation variationnelle

En l’absence d’action de la garde, soit \(\sigma=1\), la transition est la solution en forme close du problème :

\[\min_{\widetilde B}\left[\|\widetilde B-B_0\|_F^2+\frac{1}{\rho}\|\widetilde B^\top k-B_0^\top k\|^2\right]\]

sous la contrainte :

\[K^\top\widetilde B=U,\]

où \(B_0=F_0(B;k,v,\alpha,\beta)\).

L’objectif combine deux critères : rester proche de l’état produit par la transition native et préserver autant que possible sa réponse sur la clé courante.

Cette propriété d’optimalité concerne le problème épinglé sans garde active. Lorsque la garde intervient, son effet doit être pris en compte dans l’analyse de la sortie.

4.4Conservation des lectures

À partir de \(K^\top X=0\) et \(K^\top p=0\), on obtient :

\[K^\top X^+=0.\]

La composante protégée restant fixée entre événements :

\[K^\top B^+=U.\]

La conservation est donc une propriété de la transition en arithmétique exacte, à engagements fixés. Elle ne repose pas sur une réinjection périodique de la cible dans chaque écriture.

4.5Contrôle de norme et dépendance à l’état

La garde limite l’amplitude de l’écriture libre afin de maintenir la norme physique de la mémoire dans la borne prévue.

Elle utilise les entrées, les épingles et le budget de norme disponible pour le complément. Dans la construction étudiée, elle ne dépend pas de la valeur courante de \(X\). La transition reste ainsi affine par rapport au complément pendant un segment à registre fixe.

Sous les hypothèses du domaine :

\[0\leq\widehat{\beta}\|p\|^2\leq1.\]

L’opérateur appliqué à \(X\) est alors non expansif avant le facteur \(\alpha\). Pour des entrées, des engagements et des coefficients identiques, la dépendance de la sortie au complément entrant est contractante d’un facteur au plus \(\alpha\).

Cette propriété locale ne constitue pas une borne globale lorsque les clés, les cibles ou le registre varient.

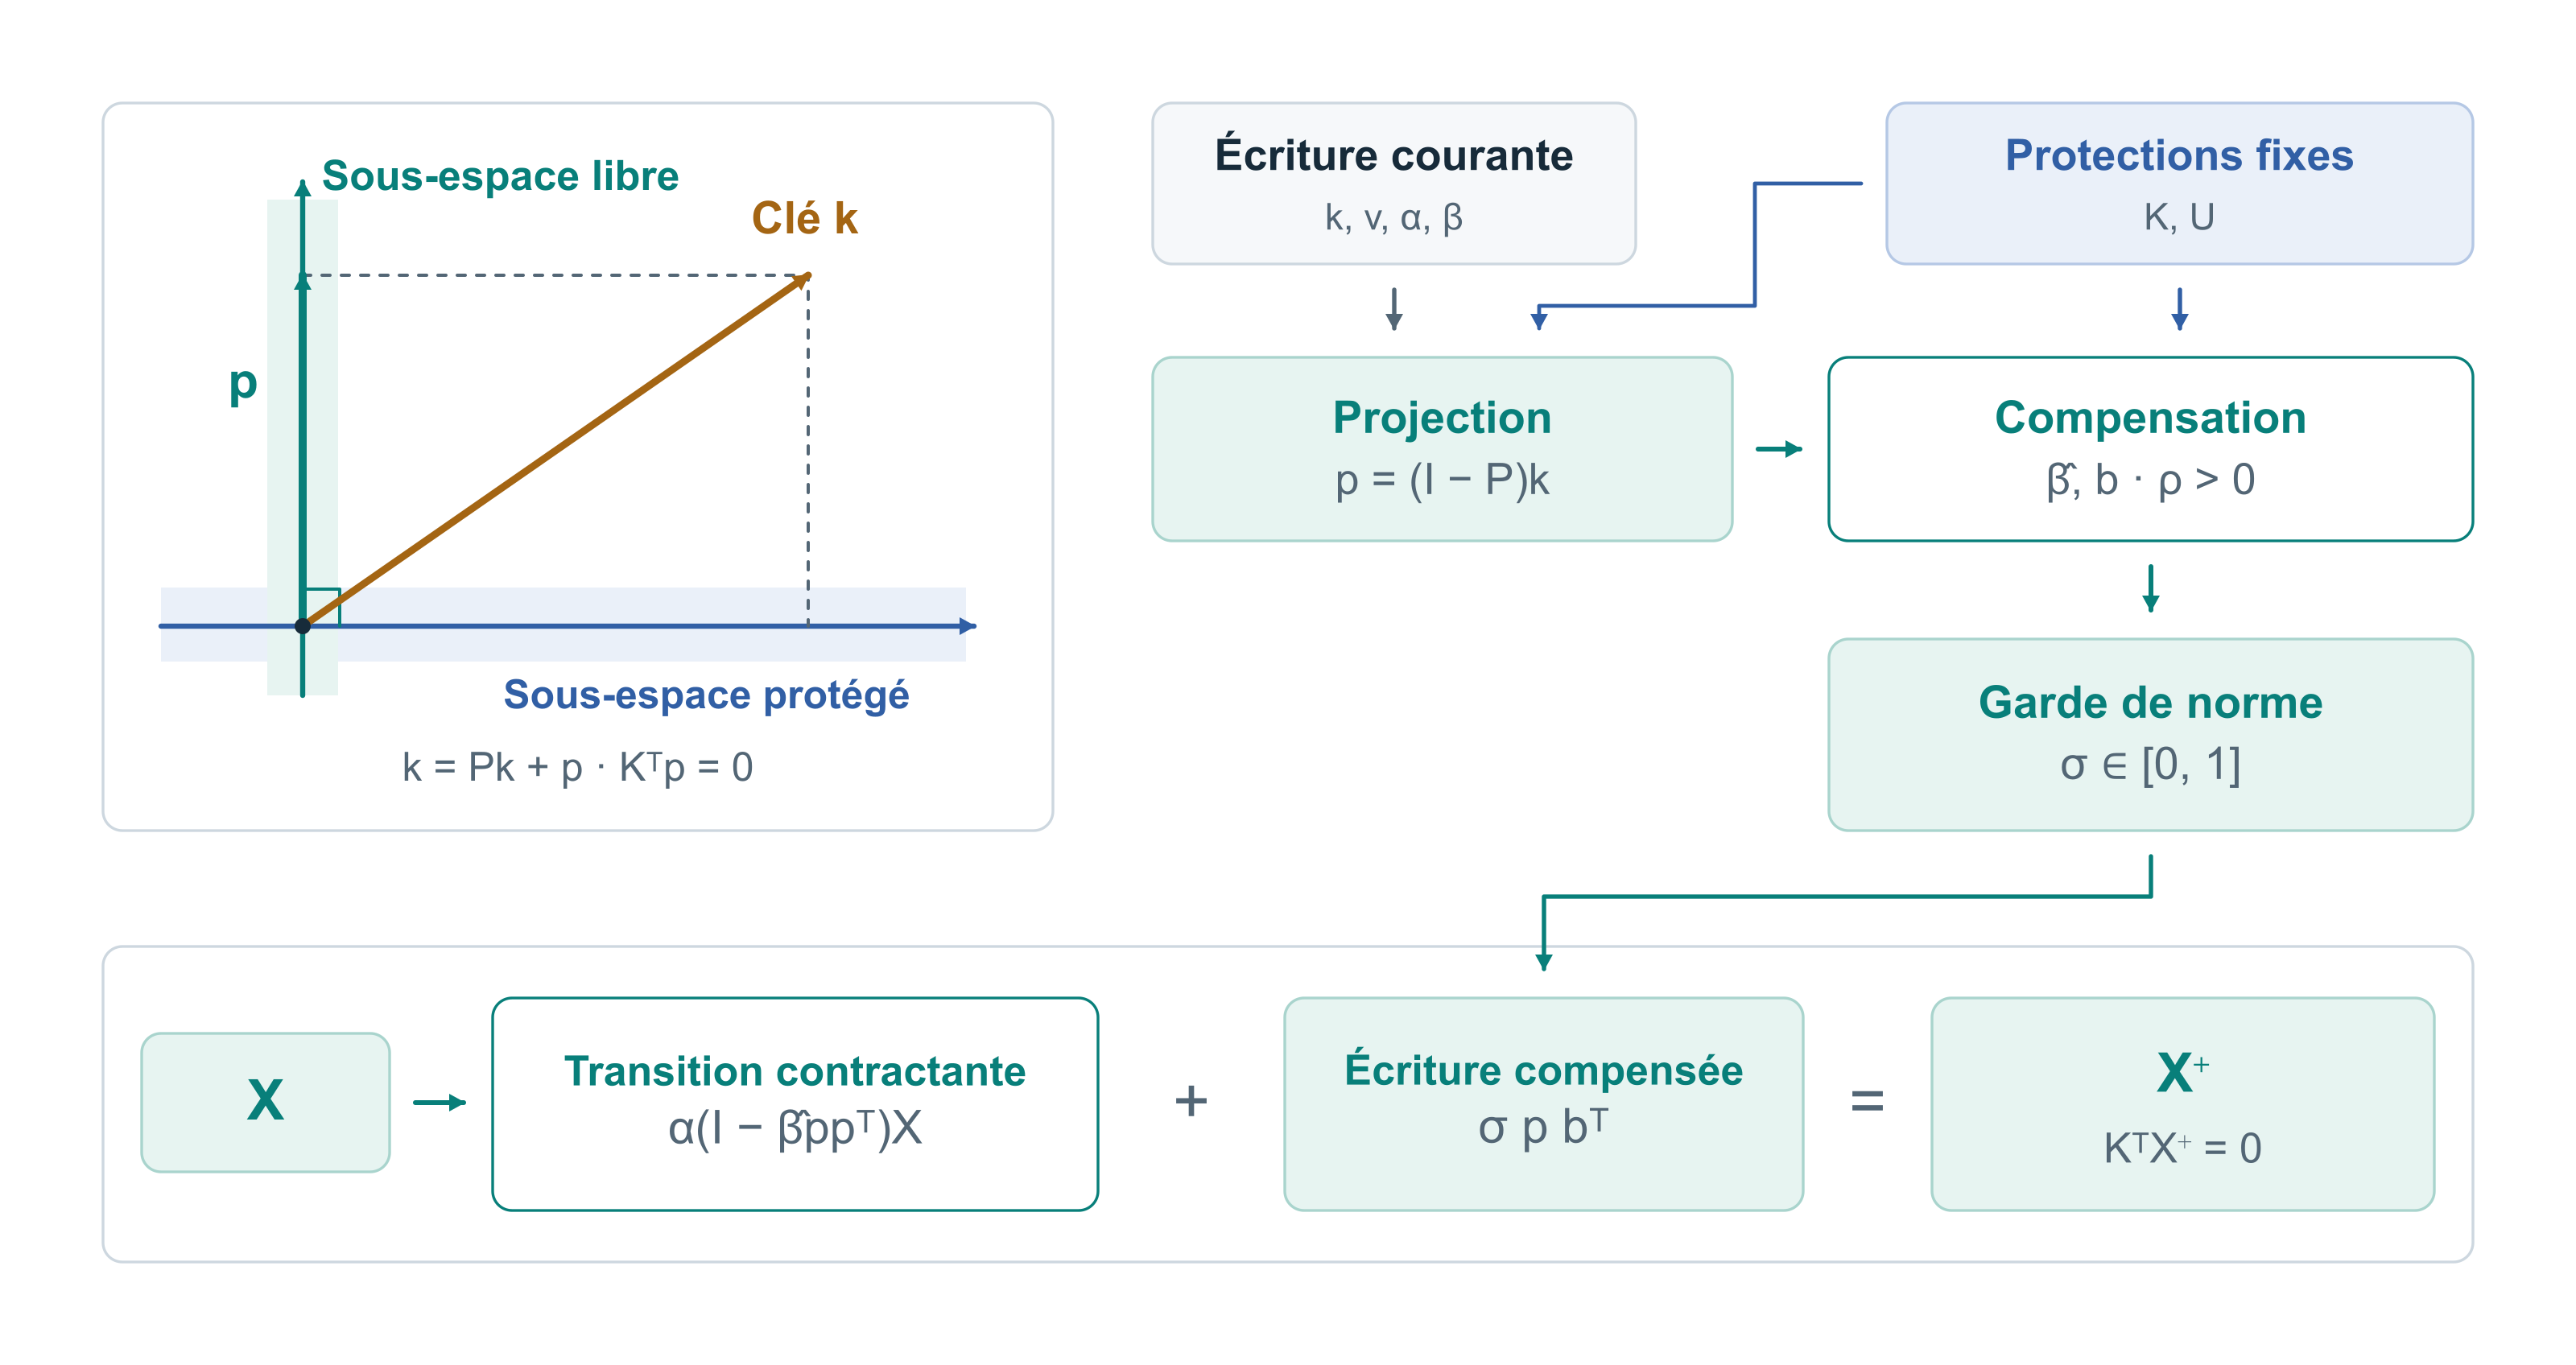
Projection de la clé hors du sous-espace protégé, compensation de l’écriture et garde de norme de la nouvelle composante libre.
La transition protégée : projection, compensation et gardeOuvrir en grand ↗
5

Admission, expiration et causalité

5.1Admission

L’admission vérifie la validité de la paire proposée, la capacité du registre et la compatibilité géométrique de l’adresse avec les engagements actifs.

La nouvelle épingle est choisie près de la cible. Le complément est ensuite reconstruit dans l’espace orthogonal au registre augmenté. Une garde de frontière contrôle la norme de l’état obtenu.

Les nouveaux objets sont préparés avant publication. Cette organisation vise à éviter qu’une admission refusée ou une erreur laisse un état partiellement modifié.

5.2Expiration

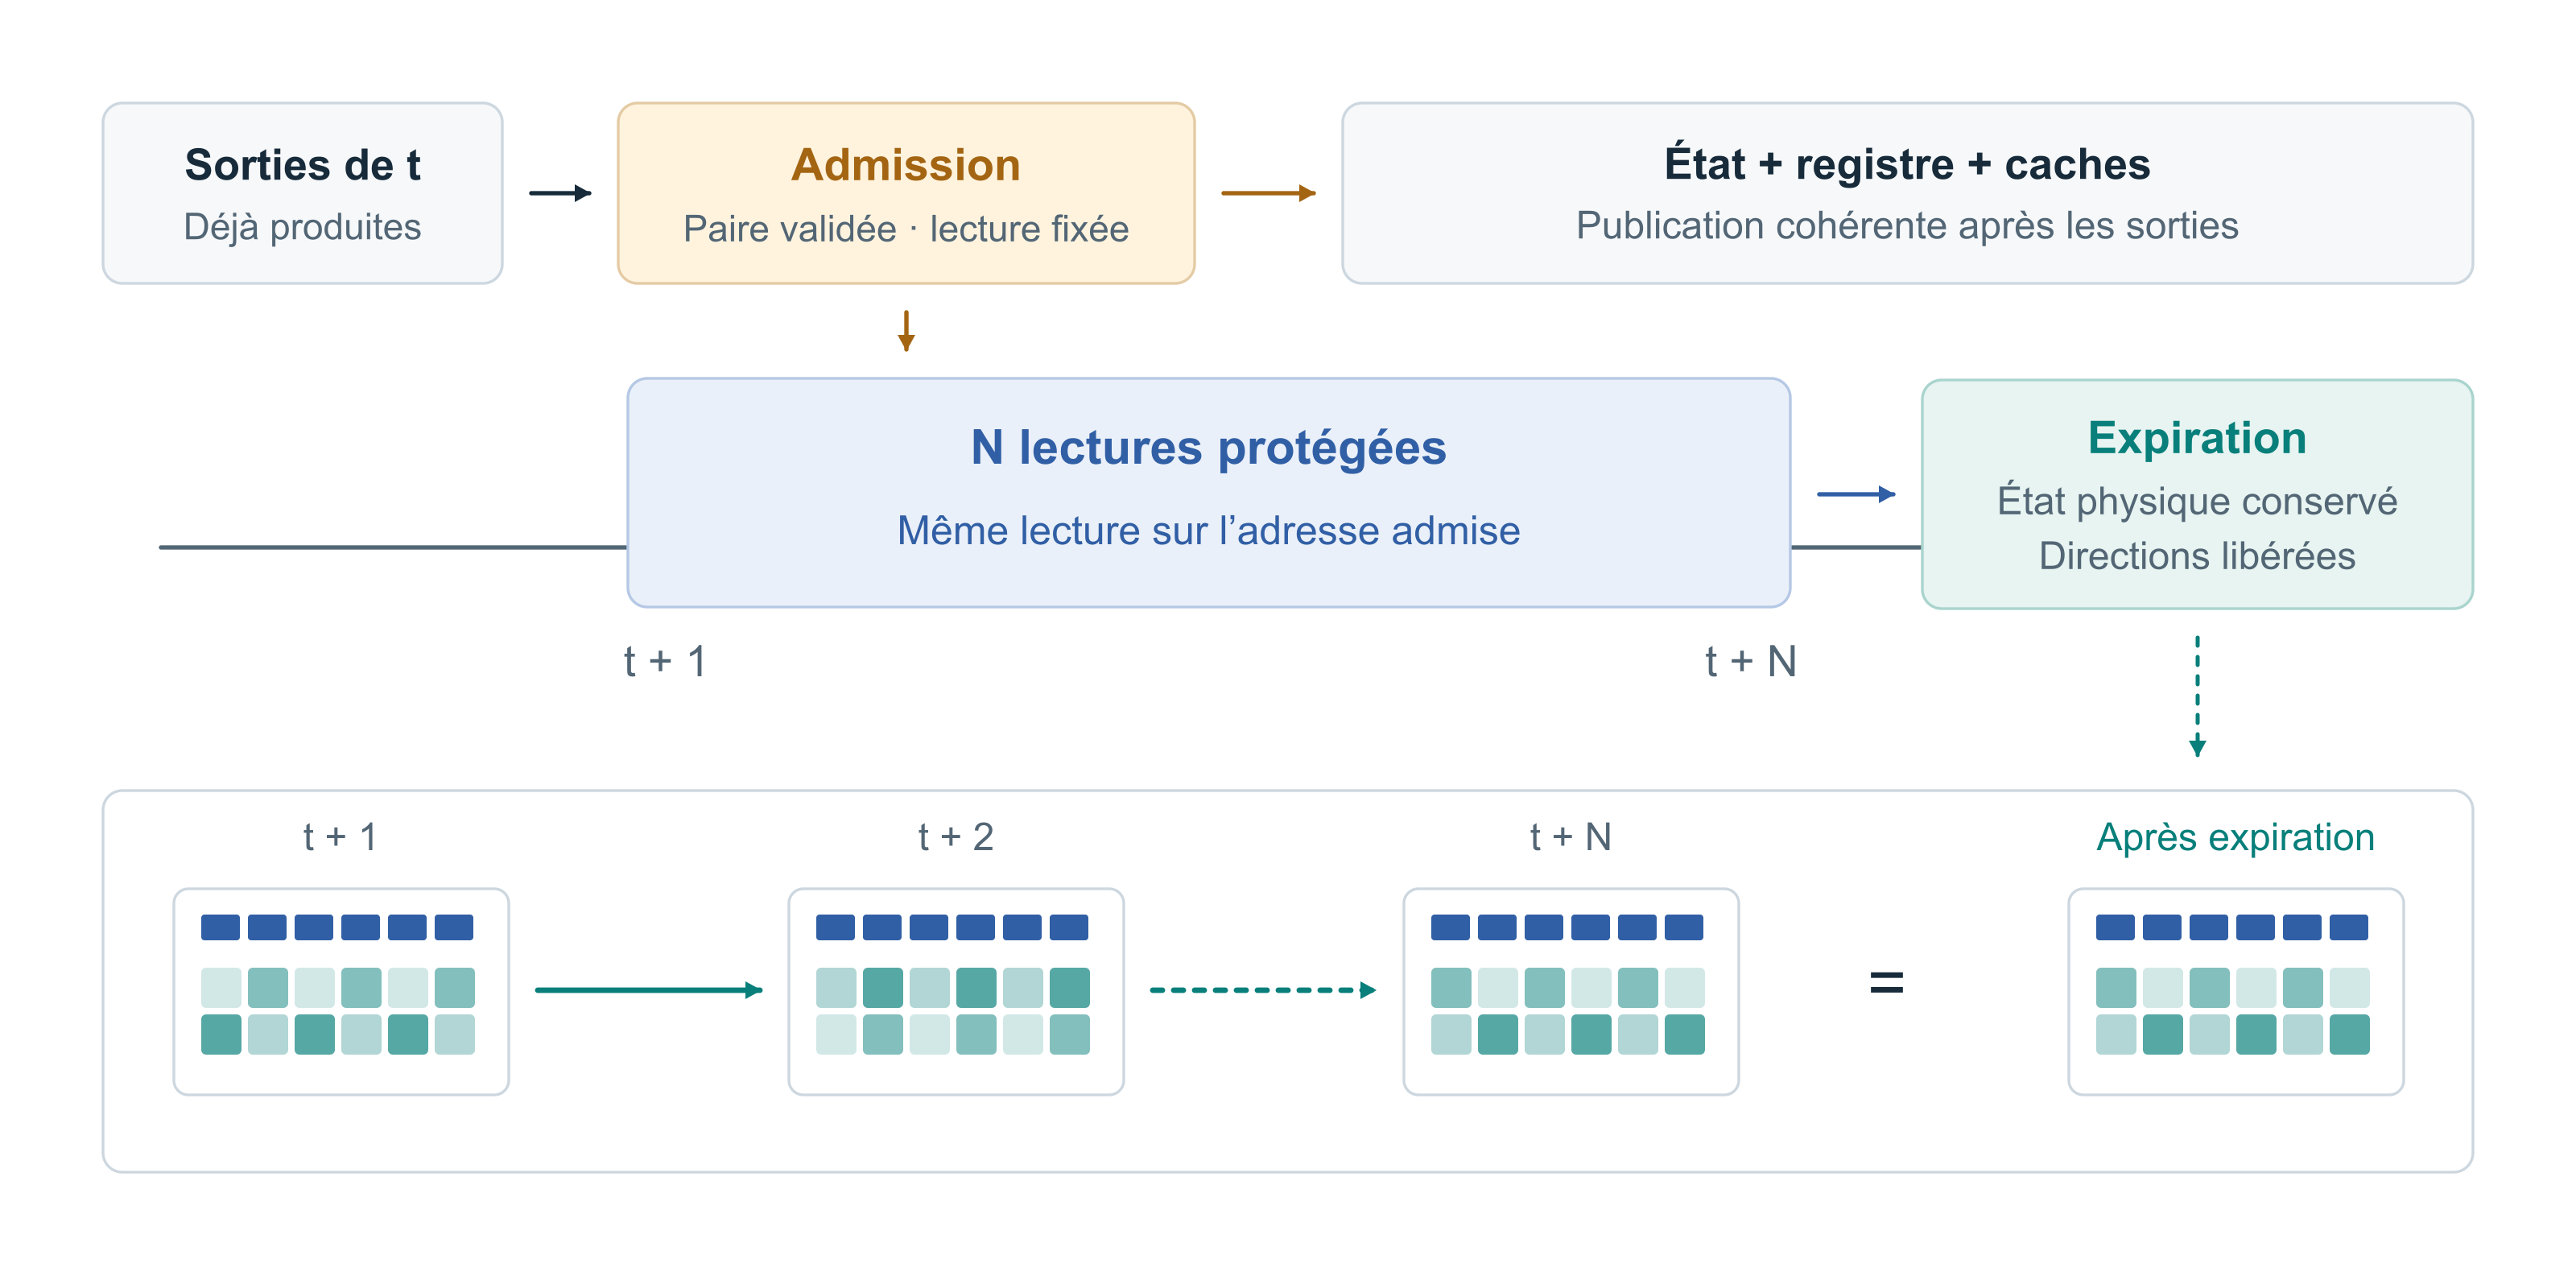
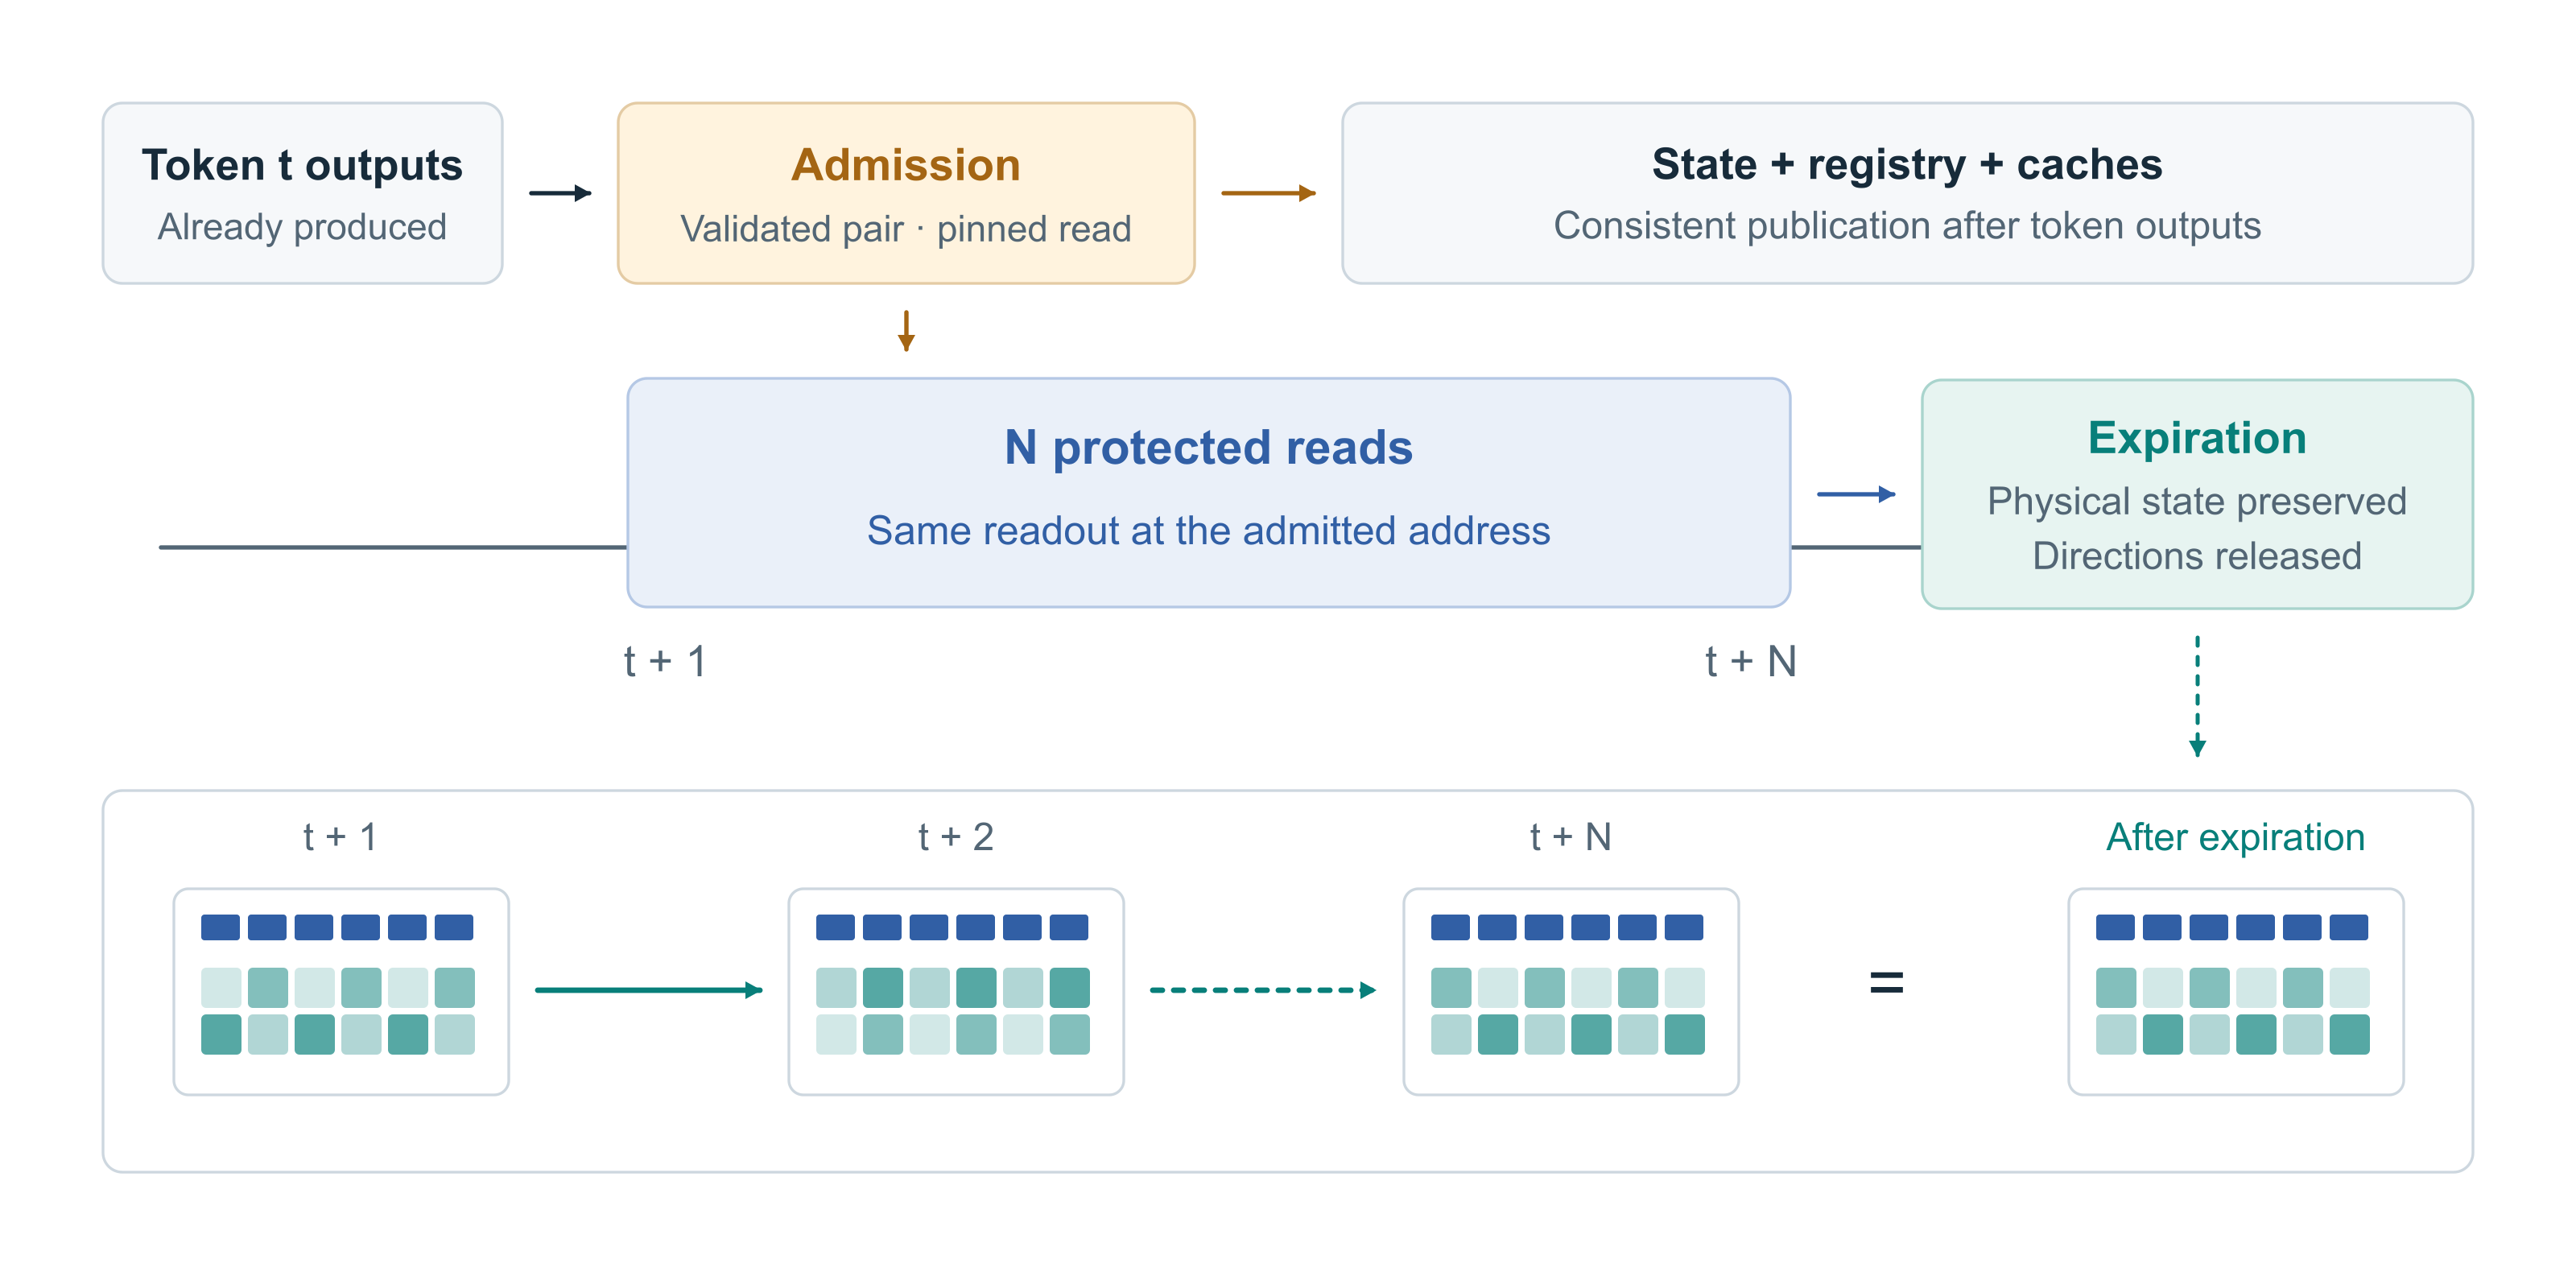
Une protection admise après le token \(t\) peut être définie sur un horizon de \(N\) lectures :

\[t+1,\ldots,t+N.\]

À son expiration, le registre est réduit et la factorisation est réorganisée.

Pour une expiration seule, avec les invariants satisfaits, la construction conserve la matrice physique en arithmétique exacte. Les directions libérées rejoignent les degrés de liberté disponibles pour les transitions suivantes.

La levée de la protection ne correspond donc pas à une remise à zéro de la mémoire.

5.3Effet futur uniquement

Les événements d’admission et d’expiration interviennent après les sorties du token concerné.

Une information récupérée au token \(t\) ne modifie pas rétroactivement les représentations ou sorties déjà produites pour \(t\). Son effet commence dans les calculs futurs.

Dans les expériences, les associations candidates proviennent de fournisseurs historiques causaux. Certaines campagnes utilisent une archive de test des paires effectivement écrites ; cette archive appartient au protocole de vérification, pas au stockage auxiliaire de la banque.

Une admission après les sorties du token t protège N lectures futures ; l’expiration libère les directions sans réinitialiser l’état physique.
Cycle de vie d’un engagement : admission, protection, expirationOuvrir en grand ↗
6

Protocole expérimental

6.1Configuration de référence

Les expériences portent sur la version gelée CP64-v2.0.

ParamètreValeur étudiée
Dimensions de la banque128 × 128
Engagements simultanés maximaux8
Cadence des événements64 tokens
Horizon de protection512 lectures
Seuil d’acquisition1/64
Seuil de rétention1/32
Norme physique maximale64
Paramètre de compensation \(\rho\)1/64
Modes numériquesFP64 et FP32 mixte

Le mode FP32 mixte utilise la simple précision pour l’état et les transitions par token, avec certains contrôles de frontière en double précision.

L’épingle est placée avec une marge par rapport au seuil d’acquisition. Le rayon configuré est :

\[\delta=\frac{1}{64}(1-2^{-10}).\]

6.2Mesures

L’erreur de rétention d’un engagement est mesurée sur la mémoire physique :

\[e_j(B)=\|B^\top r_j-v_j\|.\]

Les contrôles suivent également :

  • l’erreur à l’admission ;
  • la norme de l’état ;
  • les valeurs non finies ;
  • les changements des engagements conservés ;
  • les décisions d’admission, de refus et d’expiration ;
  • la provenance des associations proposées ;
  • l’écart entre lecteur factorisé et lecteur physique.

Ces métriques concernent des associations vectorielles. Elles ne mesurent pas directement la qualité d’une réponse textuelle.

6.3Régimes étudiés

Les campagnes comprennent sept familles d’entrées :

RégimePropriété sollicitée
LibreÉcritures et requêtes variées
CorréléProximité entre directions de lecture
ConflitÉcritures contradictoires avec des engagements actifs
SaturéÉcritures soutenues et fortes portes de conservation
OubliVariation des portes de récurrence
CodecEncodage réduit BF16 et transformations RoPE
Seuil de GramAdmissions proches des limites de conditionnement

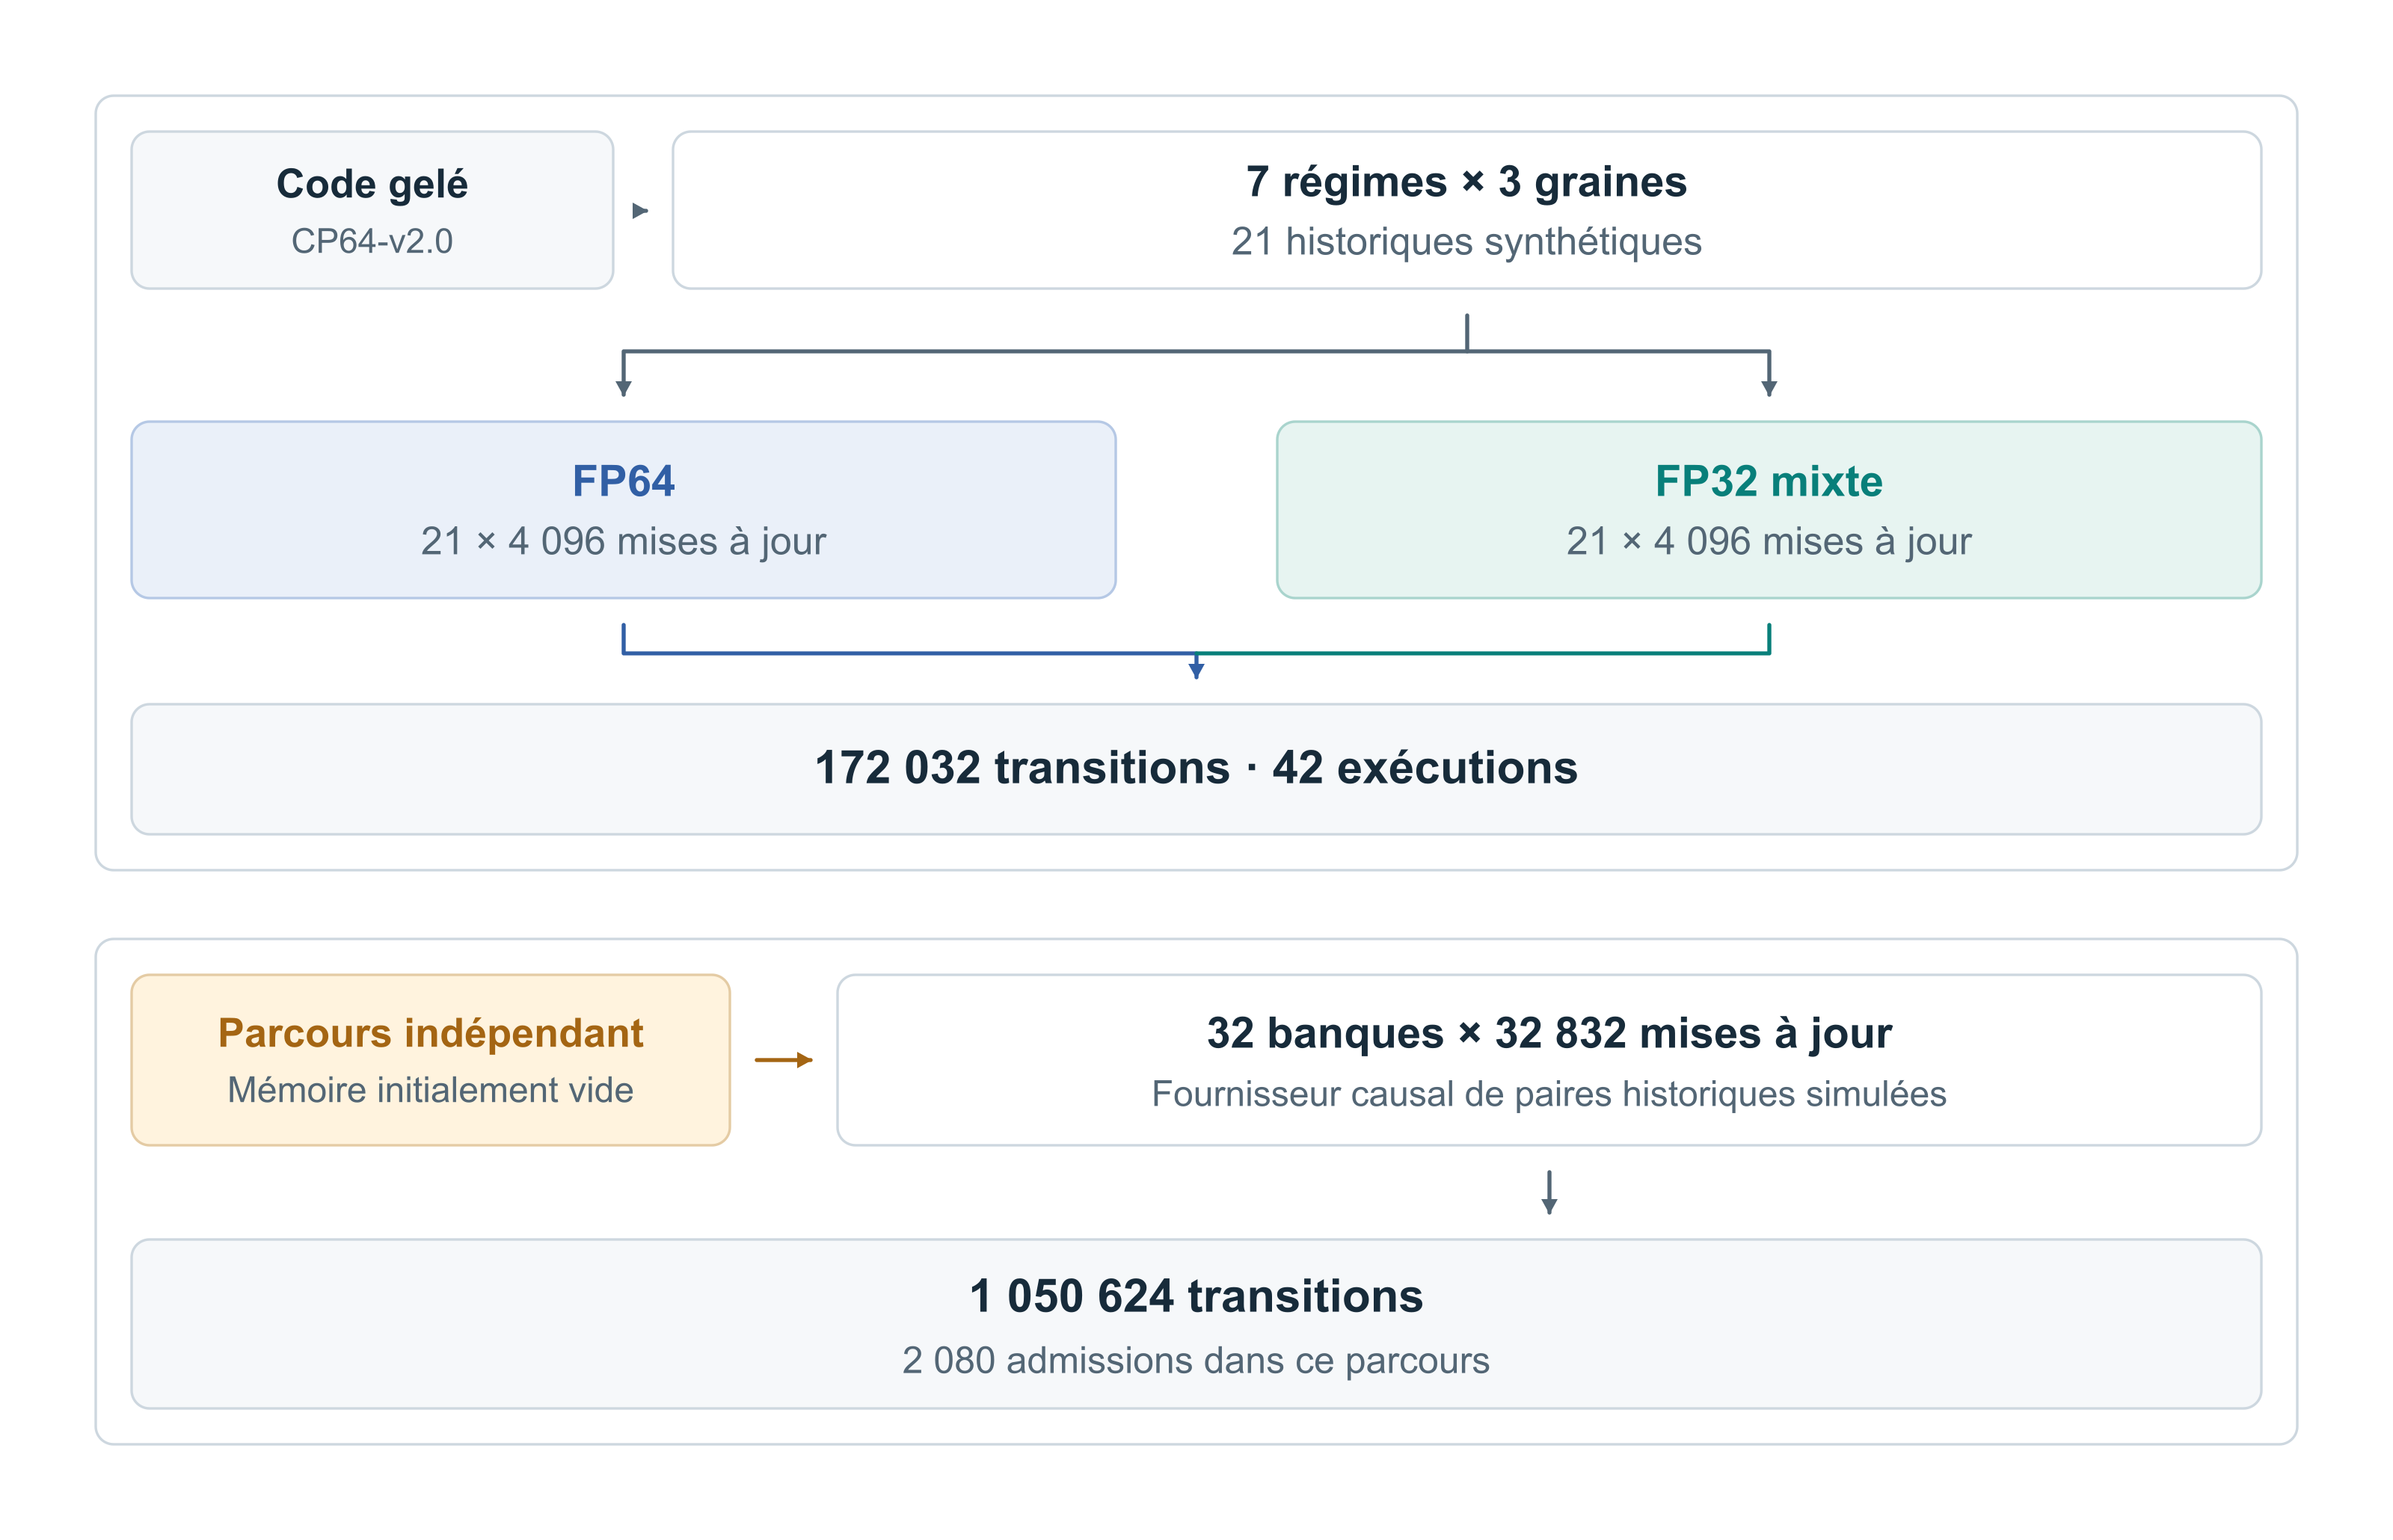
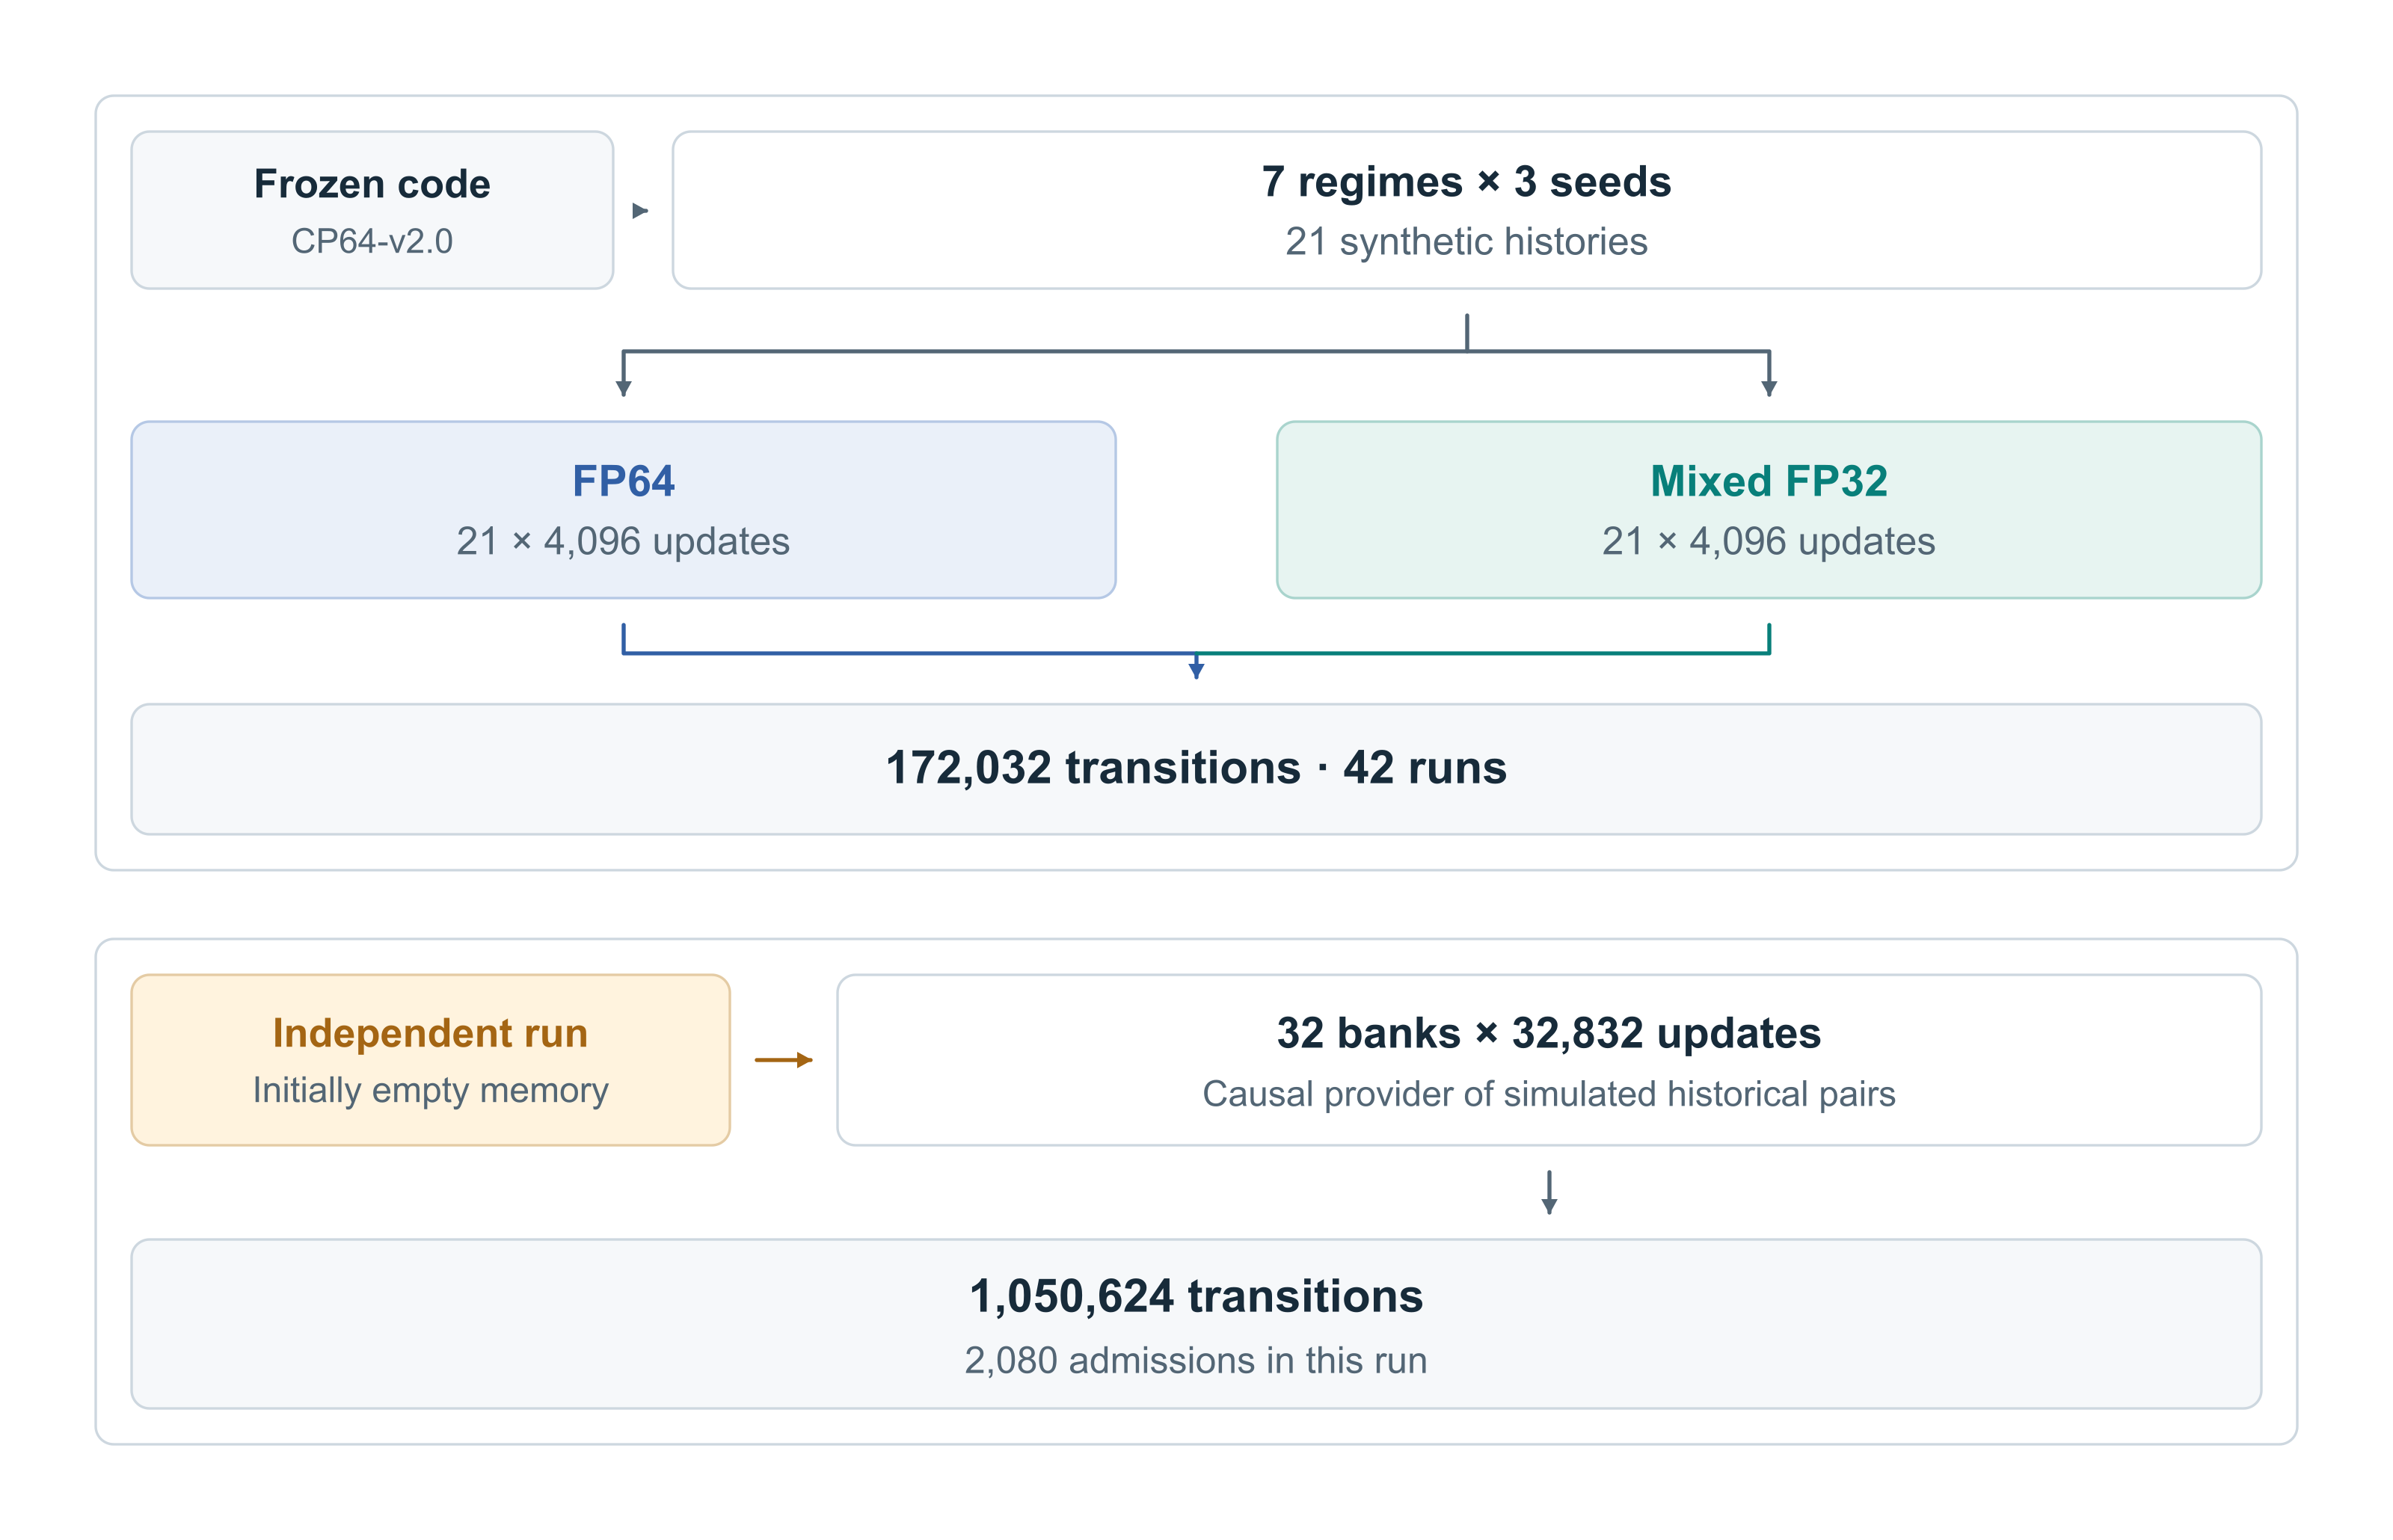
La campagne réservée utilise trois graines par régime, soit 21 historiques distincts, exécutés dans les deux modes numériques après gel du code.

Organisation de la campagne de 172 032 transitions et du parcours indépendant de 1 050 624 transitions depuis une mémoire vide.
Protocole expérimental : deux campagnes distinctesOuvrir en grand ↗
7

Résultats expérimentaux

7.1Campagne réservée : 172 032 transitions

Le volume exécuté est :

\[21\times4096\times2=172\,032\]

transitions.

MesureFP64FP32 mixte
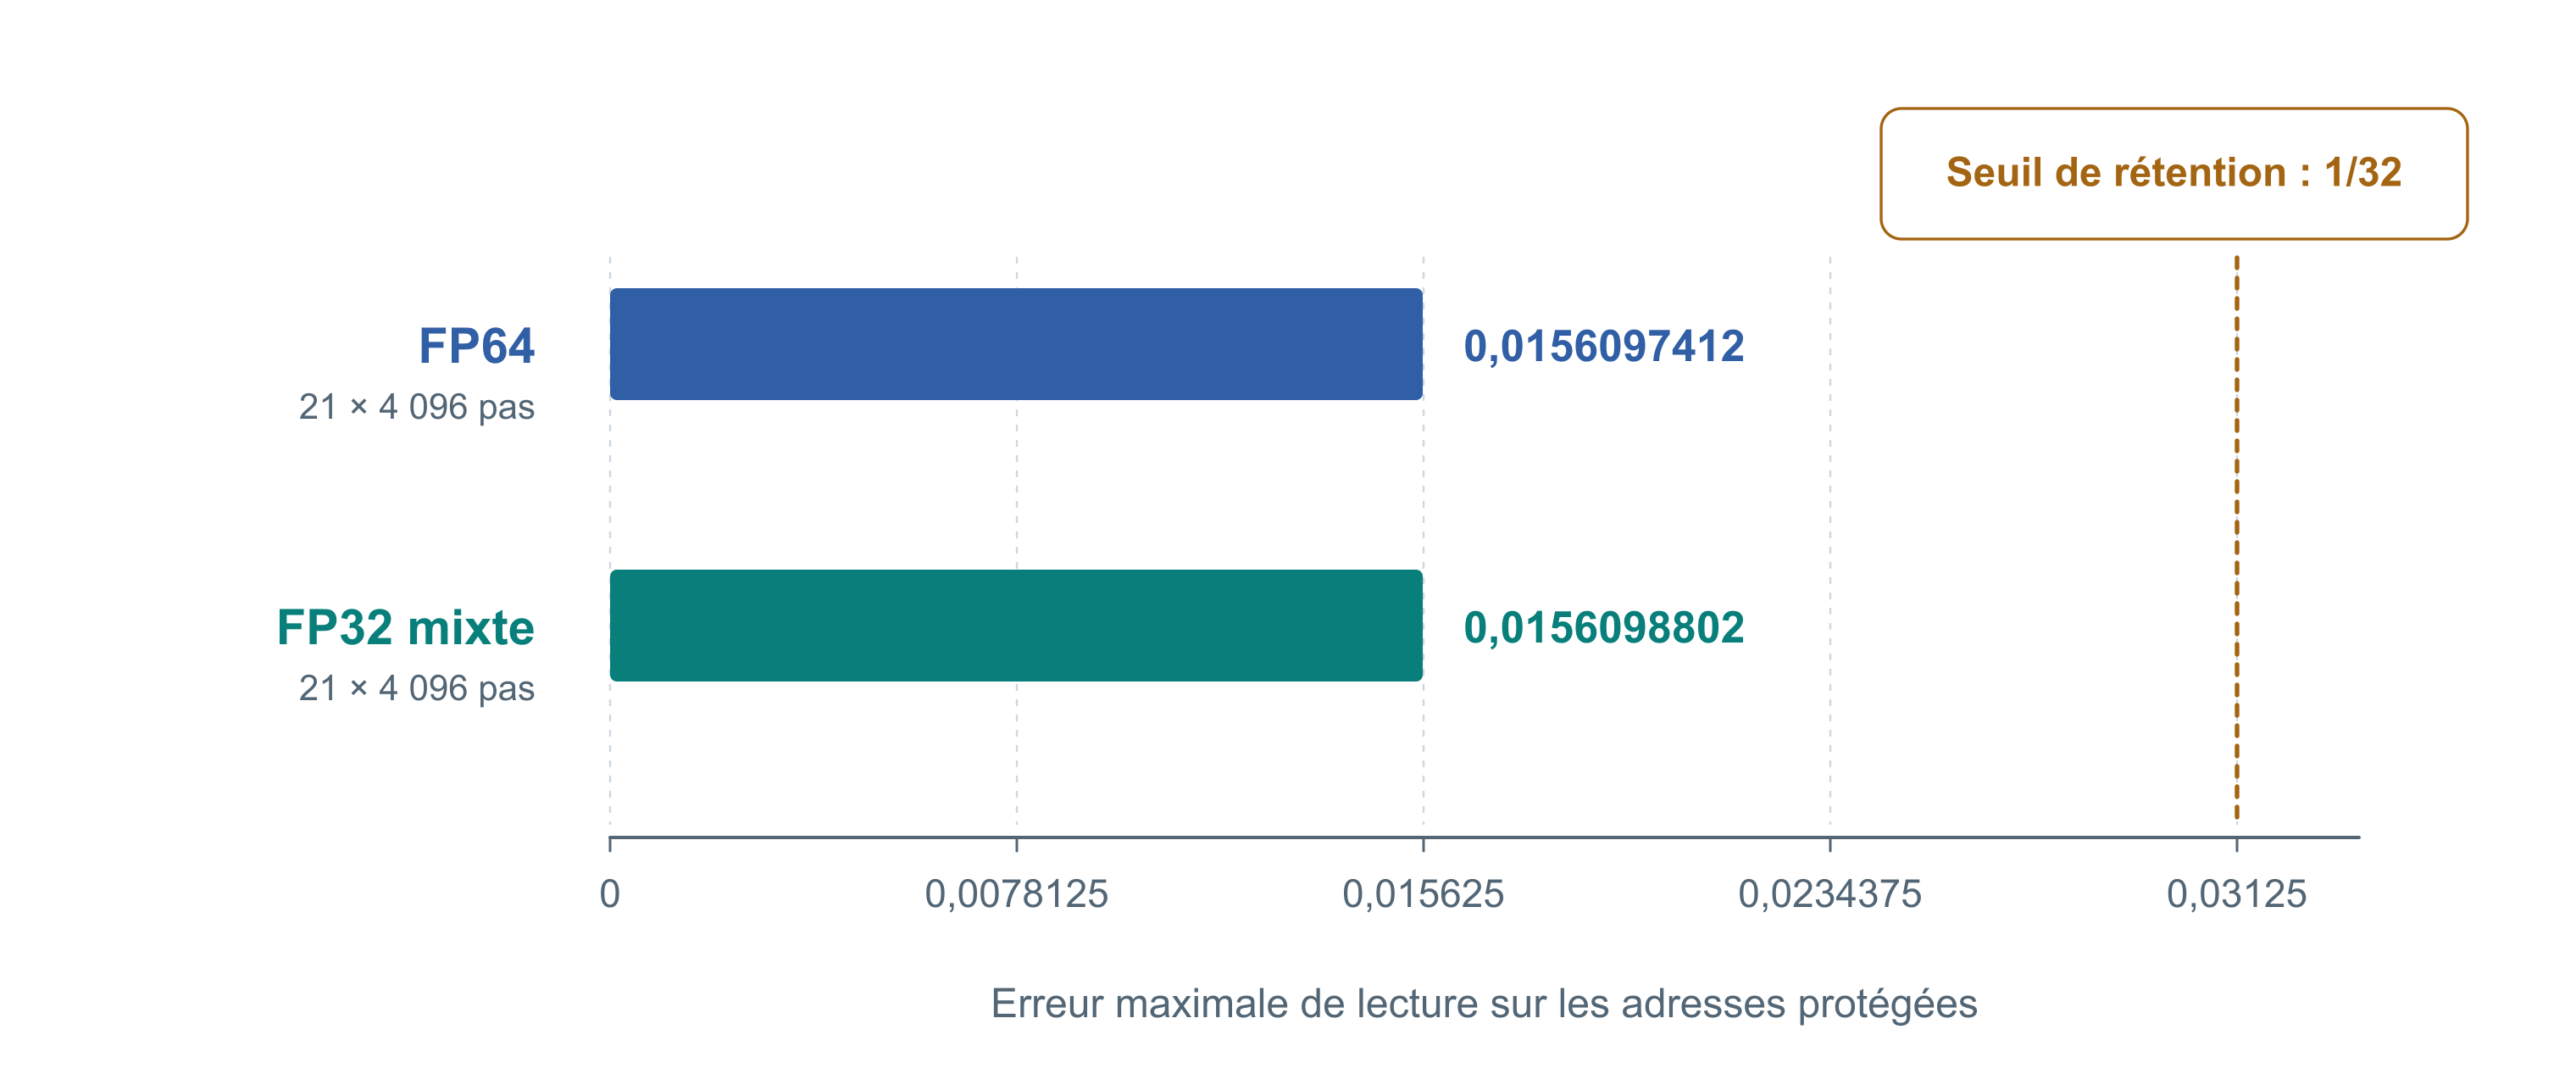
Erreur maximale de rétention0,01560974120,0156098802
Seuil de rétention0,031250,03125
Violations observées de rétention00
Erreur maximale d’admission0,01560974120,0156098076
Admissions réalisées1 1011 101
Norme maximale observée11,587811,5878

Dans cette campagne, l’erreur de rétention reste proche de l’erreur initialement introduite par l’épinglage. Les écritures suivantes n’entraînent pas de dépassement du seuil prévu.

Réserve d’audit. L’audit du générateur a toutefois identifié trois valeurs de \(\alpha\) légèrement supérieures à la limite prescrite, dans deux historiques. Les résultats ont été conservés sans modification rétroactive des entrées. Dix-neuf des 21 historiques sont entièrement conformes au domaine des portes contrôlé par cet audit.

7.2Stress géométrique

Un ensemble complémentaire comporte 24 états géométriques, chacun soumis à 512 transitions dans les deux précisions :

\[24\times512\times2=24\,576\]

transitions.

Ces états sollicitent notamment des adresses corrélées, des écritures contradictoires et une mémoire proche de la limite de norme.

En FP32 mixte :

  • l’erreur maximale de rétention est d’environ 0,01561075 ;
  • la norme maximale est d’environ 63,98 ;
  • aucune violation du seuil de rétention n’est observée.

Les états initiaux de ce lot sont construits géométriquement. Leur acquisition complète depuis une mémoire vide n’est pas établie.

7.3Comparaison CPU/GPU

Un sous-ensemble de 21 historiques de 1 024 tokens est évalué en FP64 et FP32 mixte, en exécution séquentielle et par segments.

Les deux modes GPU et les deux précisions représentent 86 016 transitions, comparées à la référence CPU.

Aucune divergence de décision n’est observée sur les événements comparés. L’écart maximal de matrice physique aux frontières atteint environ 1,76 × 10⁻⁶ en FP32 mixte.

Cette comparaison vérifie la concordance entre réalisations. Un stress GPU distinct de 32 768 transitions contrôle les lectures protégées avant expiration et ne relève aucune violation sur les parcours exécutés.

7.4Parcours acquis depuis zéro

Une vérification complémentaire utilise 32 banques initialement nulles, sur 32 832 étapes chacune :

\[32\times32\,832=1\,050\,624\]

transitions.

Le parcours comprend 2 080 admissions et un fournisseur historique scripté causal. Aucun dépassement recherché n’a été reproduit sur ce parcours.

Ce résultat porte sur une évolution effectivement exécutée depuis zéro. Il ne démontre pas que toutes les configurations géométriques difficiles sont inaccessibles, ni que les associations produites par une véritable GQA suivraient la même distribution.

Les volumes des différentes campagnes ne sont pas additionnés comme s’ils représentaient des scénarios indépendants. Certaines vérifications réutilisent des historiques ou comparent plusieurs modes d’exécution.

7.5Contrôles locaux

Des tests ciblés complètent les campagnes séquentielles.

PropriétéContrôleRésultat enregistré
Lecteur natifLecture factorisée contre matrice physique, FP64Écart maximal ≈ 5,6 × 10⁻¹⁶
Forme variationnelleComparaison à une résolution KKT indépendante, 80 casÉcart maximal ≈ 2,2 × 10⁻¹⁶
Garde activeIdentité de correction de lecture, 145 casÉcart maximal ≈ 2,3 × 10⁻¹⁵
Calcul par segmentsComparaison au calcul séquentielConcordance numérique sur les cas testés
Cas dégénérésClés nulles, portes nulles, composante libre nulle ou petiteSorties finies sur les cas testés

Ces résultats corroborent les identités implémentées dans leur domaine de test. Ils ne remplacent pas les hypothèses des démonstrations.

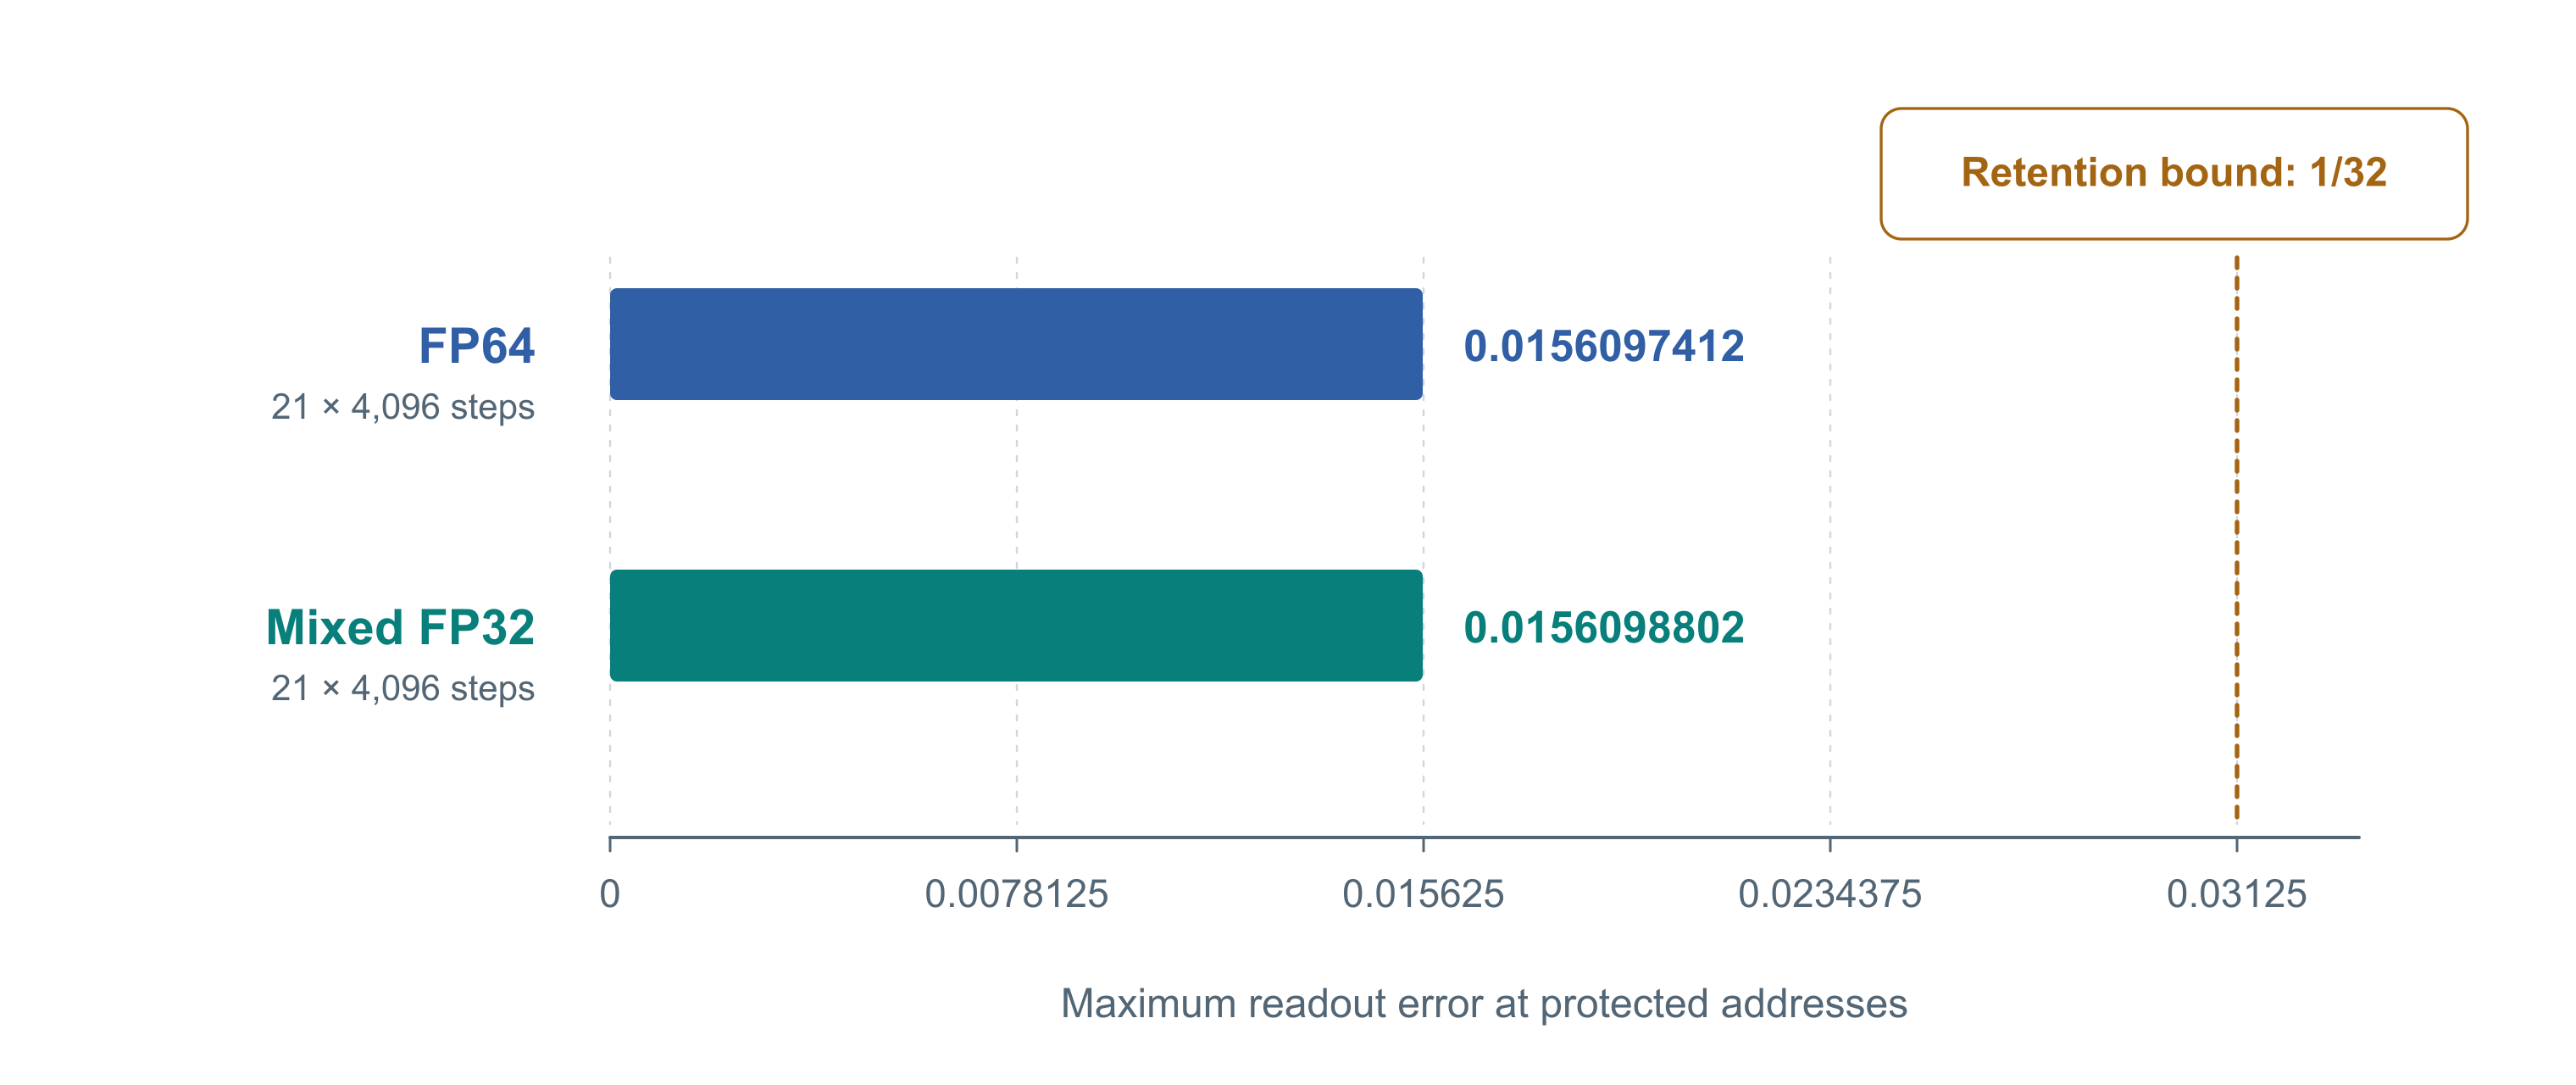
Erreur maximale de rétention dans la campagne principale en FP64 et FP32 mixte, comparée au seuil de 1/32 sur une échelle partant de zéro.
Erreur maximale de rétention mesuréeOuvrir en grand ↗
8

Réalisation informatique et ressources

Stockage

8.1

À dimensions fixées et nombre d’engagements borné, le stockage de la banque ne croît pas avec la longueur de la séquence.

Une matrice de 128 × 128 éléments FP32 occupe 65 536 octets. L’audit relève 9 104 octets d’auxiliaires persistants. L’ajout de l’offre en attente et d’une réserve logique de métadonnées conduit à un budget décrit de 10 652 octets supplémentaires.

Les buffers temporaires sont distincts de ces postes. Le prototype de préremplissage non fusionné présente notamment un pic mémoire supérieur à celui du seul état persistant.

Calcul de la transition

8.2

La transition protégée est calculée en forme close. Elle ne nécessite pas de boucle de résolution jusqu’à convergence à chaque token.

À huit engagements, le modèle algébrique fourni et reproduit estime un supplément de 15 500 additions ou multiplications par token, relativement à son comparateur natif.

La revue a identifié des opérations omises et des différences dans le compteur du code CUDA. Ce chiffre constitue donc une estimation du circuit algébrique, pas un compte matériel complet certifié.

8.3Formulation par segments

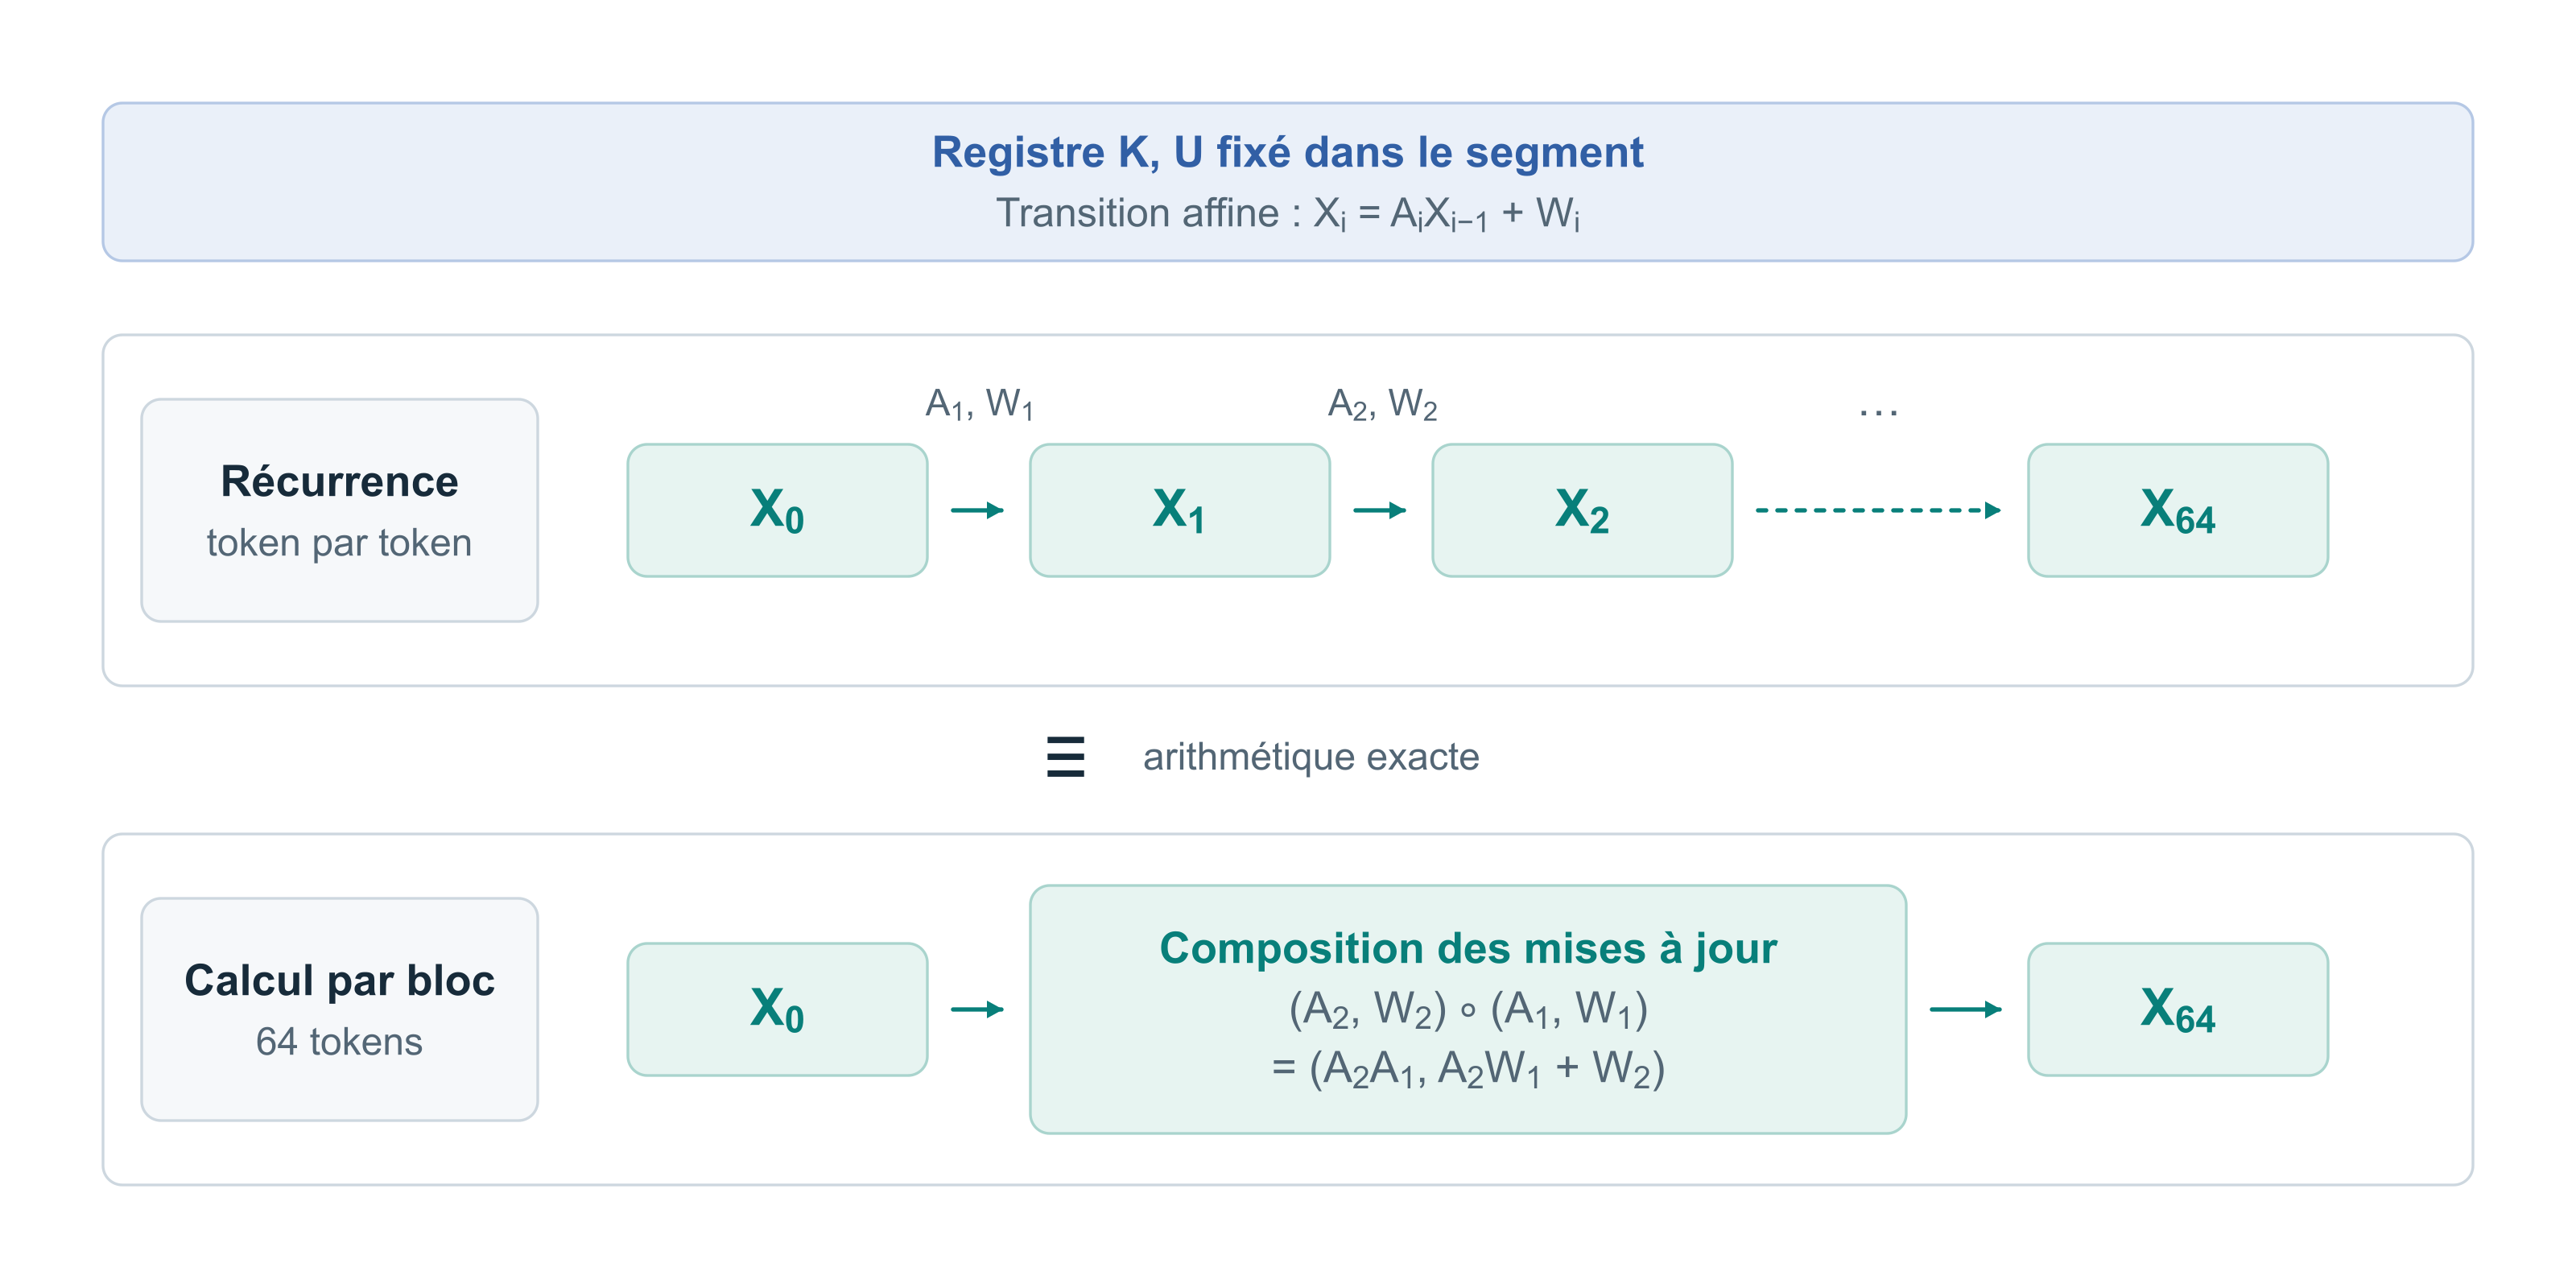
À registre fixe, la dépendance affine en \(X\) permet une formulation par blocs. La version étudiée utilise des segments de 64 tokens.

Les formulations séquentielle et par segments sont équivalentes en arithmétique exacte dans les conditions prévues. Leurs écarts flottants dépendent notamment de l’ordre des réductions.

Des microbenchmarks ont été réalisés sur RTX 2050. Certains parcours chronométrés ne renouvelaient toutefois pas réellement les engagements. Les ratios correspondants ne permettent pas de conclure sur le coût complet d’un cycle actif d’admission et d’expiration dans Sovra vNext.

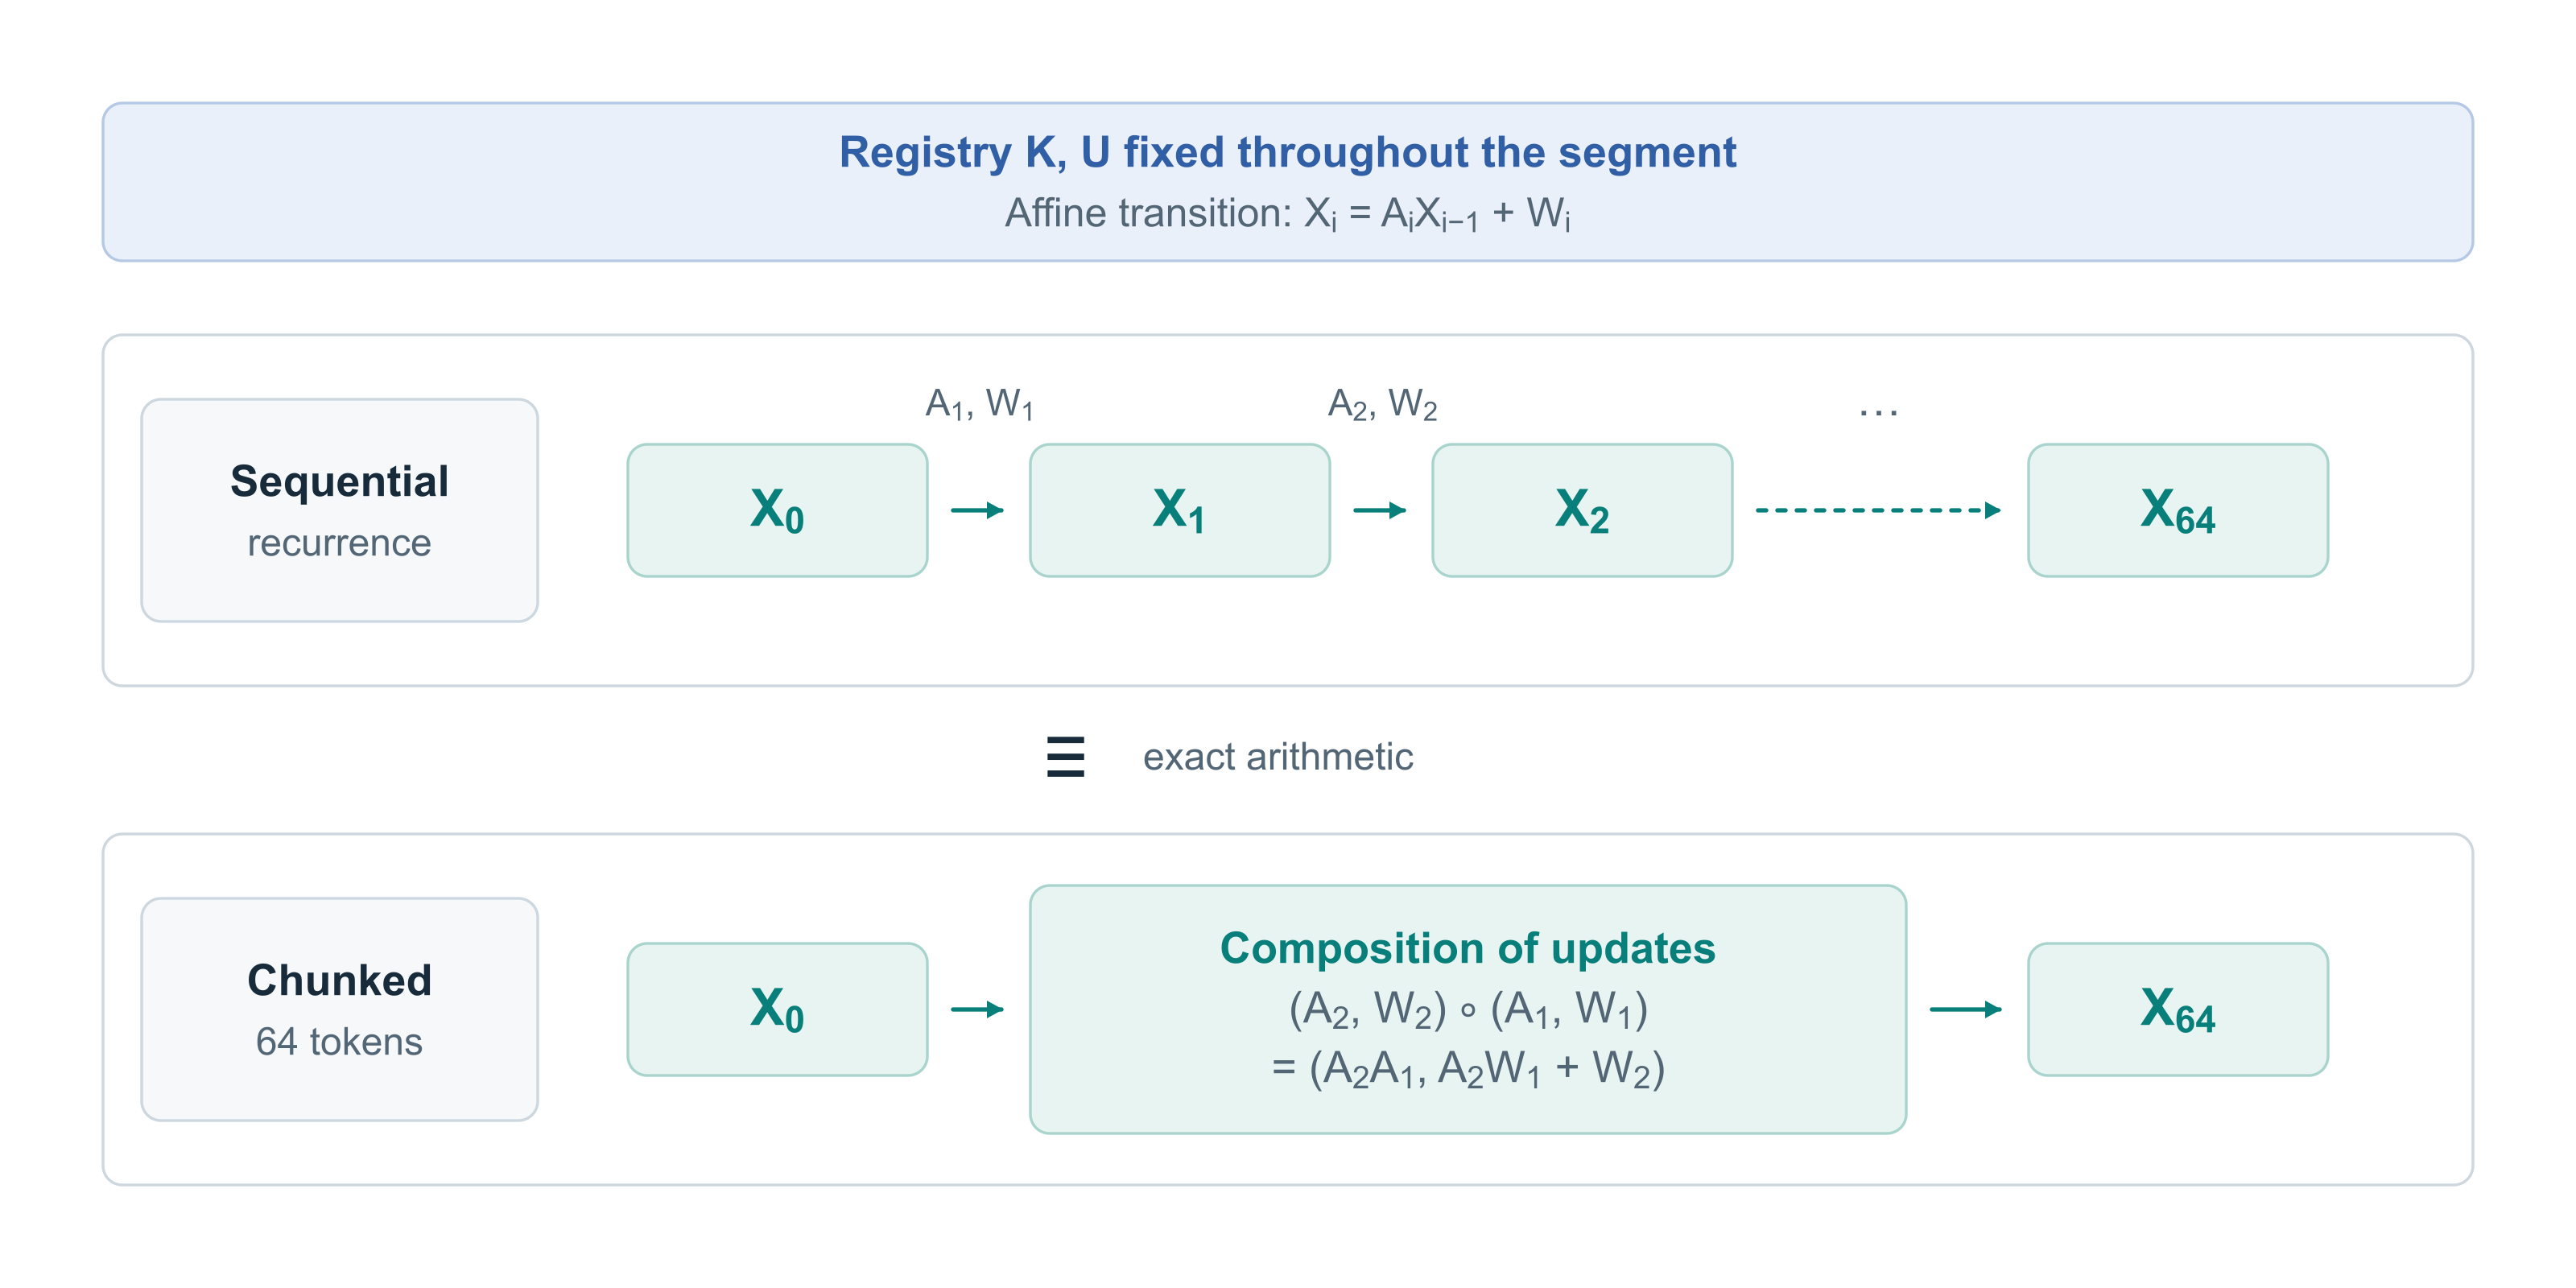
Équivalence en arithmétique exacte entre la récurrence séquentielle et la composition affine dans un segment de 64 tokens à registre fixé.
Calcul par segments de 64 tokensOuvrir en grand ↗
9

Résultats de la revue contradictoire

La revue technique distincte de la construction confirme que la factorisation, la projection des écritures et le lecteur natif réalisent le principe annoncé en arithmétique exacte.

Elle identifie également plusieurs réserves sur la version gelée.

9.1 Précision de l’admission

Sur 512 nouveaux états géométriques, six admissions CPU et neuf admissions GPU dépassent le seuil d’acquisition en FP32.

Le maximum GPU observé est \(0{,}015635001\), pour une limite d’acquisition de \(0{,}015625\). La limite de rétention de 0,03125 demeure satisfaite dans ces cas.

Le diagnostic localise une fuite du complément vers une nouvelle direction protégée lors de sa reconstruction numérique. La valeur stockée dans l’épingle respecte sa marge, mais elle ne suffit pas à borner la lecture physique finale.

Ce résultat réfute une garantie universelle d’admission pour l’implémentation flottante examinée. Il ne réfute pas l’identité de conservation en arithmétique exacte.

9.2 Interface et portée des mesures

une conversion GPU vers le mode désactivé dépendant d’emplacements inactifs, susceptibles de contaminer l’état s’ils contiennent des valeurs non finies ;
les trois portes hors domaine identifiées dans le générateur ;
des omissions dans le comptage du code CUDA ;
des parcours de performance ne couvrant pas les événements actifs annoncés.
Verdict de la revue : principe confirmé, implémentation et validation à corriger.

Interprétation et portée des résultats

Les résultats soutiennent trois conclusions.

01Invariant géométriqueLa protection de lectures sélectionnées peut être formulée comme un invariant de la mémoire native, sans figer toute la banque.
02Transition expliciteLa construction fournit une transition explicite, compatible avec une représentation compacte et un calcul par segments.
03Rétention soutenueLes campagnes montrent une rétention soutenue dans des régimes variés, et révèlent la nécessité d’évaluer la matrice physique et les erreurs de précision aux frontières.

La portée fonctionnelle reste celle d’une mémoire associative à engagements bornés. Les expériences ne démontrent pas encore une amélioration du raisonnement, une baisse des relectures documentaires ou une réduction du coût d’un agent complet.

Une évaluation intégrée devra relier les propriétés vectorielles à des mesures de tâche : utilisation effective des informations protégées, respect des contraintes, conservation des résultats intermédiaires, fréquence des récupérations et coût total.

Conclusion

NC01 étudie une consolidation temporaire directement dans la mémoire récurrente. La réalisation CP64 v2 repose sur une composante réalisant les lectures épinglées, un complément orthogonal évolutif et une transition compensée en forme close.

Sous les hypothèses de la construction, les mises à jour conservent les lectures protégées en arithmétique exacte. Les protections prennent effet uniquement sur les calculs futurs et peuvent expirer sans effacement de la matrice physique.

Les simulations et les vérifications indépendantes apportent des éléments favorables au fonctionnement du mécanisme. Les contre-exemples numériques précisent les corrections nécessaires à sa réalisation flottante.

Références

Travaux publiés sur lesquels s’appuie cet article.

Abstract

NC01 — Native Consolidation — is a research programme on retaining selected associations in the recurrent memory of a hybrid language architecture. The problem studied is how to incorporate information retrieved from the history, then preserve its reading over a defined horizon despite later updates to the state.

The construction presented factorises the memory into a component that realises the protected reads and an evolving orthogonal complement. Writes are projected onto the directions compatible with the active commitments. A compensation adjusts the recurrent transition, while a guard controls the norm of the state. The reader remains that of the native memory.

The implementation studied, CP64 v2, has a closed-form transition and a segment-wise formulation. A campaign reserved after the code freeze ran 172,032 transitions with no observed breach of the retention threshold. Complementary checks include 24,576 geometric stress transitions, CPU/GPU comparisons and a run of 1,050,624 transitions from initially zero states.

The technical review confirms the conservation principle in exact arithmetic and its realisation on the paths tested. It also identifies numerical admission defects, interface issues and measurement gaps that prevent concluding that the implementation is fully validated. The results concern the memory mechanism; its usefulness in a trained LLM remains to be measured.

Keywords

  • recurrent memory
  • LLM
  • native consolidation
  • associative memory
  • interference
  • retention
  • hybrid architectures
1

The problem studied

Hybrid architectures combining attention and recurrence have two ways of representing the past.

Attention can consult historical representations kept at each position in the sequence. Recurrence maintains a compact state, updated with every new input. The size of this state can remain constant as the sequence grows.

This compression creates an interference problem: an update meant to integrate a new association can change the answers produced for earlier addresses. The reading mechanism stays the same, but the function the memory implements changes.

NC01 studies the case where a historical association can be retrieved, proposed to the recurrent memory and admitted as a temporary commitment. The question is then how to build a transition that simultaneously allows:

  1. conservation of the reads associated with active commitments;
  2. continued updates in the available directions;
  3. a state of bounded norm;
  4. a causal implementation whose resources are independent of sequence length for a fixed configuration.
When a new write conflicts with a live commitment, the protected read takes priority.

The programme was developed as part of Sovra vNext. The construction examined in this article is CP64-v2.0, a particular implementation of NC01 based on pinned reads. It makes an explicit trade-off: when a new write conflicts with a live commitment, the protected read takes priority.

This article details the mechanism and the experiments. For a shorter introduction to the NC01 principle and its role in Sovra, see our first article on NC01.

A historical pair retrieved by attention is admitted into the recurrent memory; later writes update the free component and the reader stays native.
From retrieved history to protected memoryOpen full size ↗
2

Positioning relative to existing work

Delta-rule recurrent memories

DeltaNet

Recurrent associative memories use write rules to modify a matrix state. Work on Gated DeltaNet notably combines a delta rule, enabling targeted updates, with gates that control how much of the state is kept.

Titans also explores how attention and a neural memory updated during processing can work together. This work sets an architectural context in which the compact memory is an active part of the computation.

Temporary constraints on reads

NC01

NC01 looks more specifically at imposing temporary constraints on some reads of this memory.

The mathematical tools involved — orthogonal projection, matrix factorisation and constrained quadratic optimisation — are classical. The contribution studied is their combination with a recurrent transition, causal admission and a bounded commitment life cycle.

This problem differs from external document retrieval. Retrieval-Augmented Generation provides access to a non-parametric memory, such as a document index. NC01 acts on the recurrent state used during computation. External or attention-based retrieval can supply a candidate association, but its retention is then handled in the native memory.

3

Formalising memory and commitments

3.1Native state and reader

A memory bank is represented by a matrix:

\[B\in\mathbb{R}^{d_k\times d_v}.\]

For a query \(q\in\mathbb{R}^{d_k}\), the reader returns:

\[\operatorname{Read}(B,q)=B^\top q.\]

The reference native transition belongs to a family of gated delta rules:

\[F_0(B;k,v,\alpha,\beta)=\alpha(I-\beta kk^\top)B+\beta kv^\top.\]

The key \(k\) sets the direction of the write, \(v\) its value, \(\alpha\) the retention factor and \(\beta\) the strength of the update.

In the domain studied, keys and values are norm-bounded, with \(0\leq\beta\leq1\) and \(0\leq\alpha<1\).

3.2Committing a read

A commitment links an address \(r_j\) to a historical target \(v_j\). At admission, the mechanism sets a pinned value \(u_j\), close to that target.

This distinction matters: retention applies to \(u_j\), while the acquisition error is measured between \(u_j\) and \(v_j\).

For \(m\) active commitments, define:

\[K=[r_1,\ldots,r_m],\qquad U=\begin{bmatrix}u_1^\top\\ \vdots\\ u_m^\top\end{bmatrix},\qquad H=K^\top K.\]

The conditioning of \(H\) controls the geometric compatibility of the addresses. The configuration studied nominally requires:

\[H\succeq \frac14 I.\]

Protected addresses therefore cannot be arbitrarily redundant.

3.3State decomposition

The memory is represented as:

\[\boxed{B=KH^{-1}U+X},\qquad K^\top X=0.\]

The first component realises the pinned reads. The complement \(X\) holds the degrees of freedom orthogonal to the protected addresses.

It follows that:

\[K^\top B=K^\top KH^{-1}U+K^\top X=U.\]

This identity is the central invariant of the construction.

The factorised reader remains equivalent to that of the physical matrix:

\[B^\top q=U^\top H^{-1}K^\top q+X^\top q.\]

The two terms contribute to a single linear map. The factorisation does not create a second reader that would consult the historical targets.

Decomposition of the state B into a protected component and an orthogonal complement X, with conservation of the reads U and the identity of the reader Bᵀq.
State decomposition: protected reads and free complementOpen full size ↗
4

Building the protected transition

4.1Projecting the write key

The projector onto the subspace of protected addresses is:

\[P_K=KH^{-1}K^\top.\]

The free component of a new key is:

\[p=(I-P_K)k.\]

It satisfies:

\[K^\top p=0.\]

A correction carried by \(p\) can therefore modify the complement without moving the pinned reads, provided orthogonality is actually maintained.

4.2Compensating the transition

The projection is completed by an adjustment of the write and recurrence coefficients.

With commitments fixed, the transition reads:

\[X^+=\alpha(I-\widehat{\beta}pp^\top)X+\sigma p b^\top.\]

The coefficients are defined by:

\[c=H^{-1}K^\top k,\qquad y=U^\top c,\]
\[\tau^2=\|p\|^2,\qquad \pi^2=\|P_Kk\|^2,\qquad g=\frac{1}{\tau^2+\rho},\]
\[\widehat{\beta}=\beta(1+\pi^2g),\]
\[b=\widehat{\beta}v-\left[\alpha\beta+(1-\alpha+\alpha\beta\pi^2)g\right]y.\]

The parameter \(\rho>0\) sets the compensation trade-off. It avoids a singular division when the free component of the key tends to zero.

The factor \(\sigma\in[0,1]\) is the norm guard.

4.3Variational interpretation

When the guard is inactive, that is \(\sigma=1\), the transition is the closed-form solution of the problem:

\[\min_{\widetilde B}\left[\|\widetilde B-B_0\|_F^2+\frac{1}{\rho}\|\widetilde B^\top k-B_0^\top k\|^2\right]\]

subject to the constraint:

\[K^\top\widetilde B=U,\]

where \(B_0=F_0(B;k,v,\alpha,\beta)\).

The objective combines two criteria: staying close to the state produced by the native transition and preserving, as far as possible, its response on the current key.

This optimality property concerns the pinned problem without an active guard. When the guard acts, its effect must be taken into account in analysing the output.

4.4Conservation of reads

From \(K^\top X=0\) and \(K^\top p=0\), we obtain:

\[K^\top X^+=0.\]

Since the protected component stays fixed between events:

\[K^\top B^+=U.\]

Conservation is therefore a property of the transition in exact arithmetic, with commitments fixed. It does not rely on periodically re-injecting the target into each write.

4.5Norm control and state dependence

The guard limits the amplitude of the free write so as to keep the physical norm of the memory within the intended bound.

It uses the inputs, the pins and the norm budget available to the complement. In the construction studied, it does not depend on the current value of \(X\). The transition therefore remains affine in the complement over a segment with a fixed register.

Under the assumptions of the domain:

\[0\leq\widehat{\beta}\|p\|^2\leq1.\]

The operator applied to \(X\) is then non-expansive before the factor \(\alpha\). For identical inputs, commitments and coefficients, the dependence of the output on the incoming complement is contractive by a factor of at most \(\alpha\).

This local property is not a global bound when keys, targets or the register vary.

Projection of the key out of the protected subspace, compensation of the write and norm guard on the new free component.
The protected transition: projection, compensation and guardOpen full size ↗
5

Admission, expiration and causality

5.1Admission

Admission checks the validity of the proposed pair, the capacity of the register and the geometric compatibility of the address with the active commitments.

The new pin is chosen near the target. The complement is then rebuilt in the space orthogonal to the augmented register. A boundary guard controls the norm of the resulting state.

New objects are prepared before publication. This organisation aims to prevent a refused admission or an error from leaving a partially modified state.

5.2Expiration

A protection admitted after token \(t\) can be defined over a horizon of \(N\) reads:

\[t+1,\ldots,t+N.\]

When it expires, the register is reduced and the factorisation is reorganised.

For an expiration alone, with the invariants satisfied, the construction preserves the physical matrix in exact arithmetic. The freed directions join the degrees of freedom available to later transitions.

Lifting the protection is therefore not a reset of the memory.

5.3Future effect only

Admission and expiration events occur after the outputs of the token concerned.

Information retrieved at token \(t\) does not retroactively change the representations or outputs already produced for \(t\). Its effect begins in future computations.

In the experiments, candidate associations come from causal history providers. Some campaigns use a test archive of the pairs actually written; this archive belongs to the verification protocol, not to the bank’s auxiliary storage.

An admission after the outputs of token t protects N future reads; expiration frees the directions without resetting the physical state.
Life cycle of a commitment: admission, protection, expirationOpen full size ↗
6

Experimental protocol

6.1Reference configuration

The experiments concern the frozen version CP64-v2.0.

ParameterValue studied
Bank dimensions128 × 128
Maximum simultaneous commitments8
Event cadence64 tokens
Protection horizon512 reads
Acquisition threshold1/64
Retention threshold1/32
Maximum physical norm64
Compensation parameter \(\rho\)1/64
Numerical modesFP64 and mixed FP32

The mixed FP32 mode uses single precision for the state and per-token transitions, with some boundary checks in double precision.

The pin is placed with a margin relative to the acquisition threshold. The configured radius is:

\[\delta=\frac{1}{64}(1-2^{-10}).\]

6.2Measurements

The retention error of a commitment is measured on the physical memory:

\[e_j(B)=\|B^\top r_j-v_j\|.\]

The checks also track:

  • the error at admission;
  • the norm of the state;
  • non-finite values;
  • changes to retained commitments;
  • admission, refusal and expiration decisions;
  • the provenance of the proposed associations;
  • the gap between the factorised reader and the physical reader.

These metrics concern vector associations. They do not directly measure the quality of a text answer.

6.3Regimes studied

The campaigns include seven families of inputs:

RegimeProperty exercised
FreeVaried writes and queries
CorrelatedCloseness between read directions
ConflictWrites that contradict active commitments
SaturatedSustained writes and strong retention gates
ForgettingVariation of the recurrence gates
CodecReduced BF16 encoding and RoPE transformations
Gram thresholdAdmissions close to the conditioning limits

The reserved campaign uses three seeds per regime, that is 21 distinct histories, run in both numerical modes after the code freeze.

Organisation of the 172,032-transition campaign and of the independent 1,050,624-transition run from an empty memory.
Experimental protocol: two separate campaignsOpen full size ↗
7

Experimental results

7.1Reserved campaign: 172,032 transitions

The volume run is:

\[21\times4096\times2=172\,032\]

transitions.

MeasureFP64Mixed FP32
Maximum retention error0.01560974120.0156098802
Retention threshold0.031250.03125
Observed retention violations00
Maximum admission error0.01560974120.0156098076
Admissions performed1,1011,101
Maximum observed norm11.587811.5878

In this campaign, the retention error stays close to the error initially introduced by pinning. Later writes do not cause the intended threshold to be exceeded.

Audit caveat. The audit of the generator did identify three values of \(\alpha\) slightly above the prescribed limit, in two histories. The results were kept without retroactively changing the inputs. Nineteen of the 21 histories fully comply with the gate domain checked by this audit.

7.2Geometric stress

A complementary set contains 24 geometric states, each subjected to 512 transitions in both precisions:

\[24\times512\times2=24\,576\]

transitions.

These states exercise correlated addresses, contradictory writes and a memory close to the norm limit, among other things.

In mixed FP32:

  • the maximum retention error is about 0.01561075;
  • the maximum norm is about 63.98;
  • no breach of the retention threshold is observed.

The initial states of this batch are built geometrically. Their full acquisition from an empty memory is not established.

7.3CPU/GPU comparison

A subset of 21 histories of 1,024 tokens is evaluated in FP64 and mixed FP32, in sequential and segment-wise execution.

The two GPU modes and the two precisions represent 86,016 transitions, compared with the CPU reference.

No decision divergence is observed on the events compared. The maximum gap in the physical matrix at boundaries reaches about 1.76 × 10⁻⁶ in mixed FP32.

This comparison checks agreement between implementations. A separate GPU stress run of 32,768 transitions checks protected reads before expiration and finds no violation on the paths run.

7.4Run acquired from zero

A complementary check uses 32 initially zero banks, over 32,832 steps each:

\[32\times32\,832=1\,050\,624\]

transitions.

The run includes 2,080 admissions and a scripted causal history provider. No sought-after breach was reproduced on this run.

This result concerns a trajectory actually run from zero. It does not show that all difficult geometric configurations are unreachable, nor that the associations produced by a real GQA would follow the same distribution.

The volumes of the different campaigns are not added together as if they were independent scenarios. Some checks reuse histories or compare several execution modes.

7.5Local checks

Targeted tests complement the sequential campaigns.

PropertyCheckRecorded result
Native readerFactorised read against physical matrix, FP64Maximum gap ≈ 5.6 × 10⁻¹⁶
Variational formComparison with an independent KKT solve, 80 casesMaximum gap ≈ 2.2 × 10⁻¹⁶
Active guardRead-correction identity, 145 casesMaximum gap ≈ 2.3 × 10⁻¹⁵
Segment-wise computationComparison with sequential computationNumerical agreement on the cases tested
Degenerate casesZero keys, zero gates, zero or small free componentFinite outputs on the cases tested

These results corroborate the implemented identities within their test domain. They do not replace the assumptions of the proofs.

Maximum retention error in the main campaign in FP64 and mixed FP32, compared with the 1/32 threshold on a scale starting at zero.
Maximum measured retention errorOpen full size ↗
8

Implementation and resources

Storage

8.1

With fixed dimensions and a bounded number of commitments, the storage of the bank does not grow with sequence length.

A 128 × 128 matrix of FP32 elements takes 65,536 bytes. The audit finds 9,104 bytes of persistent auxiliaries. Adding the pending offer and a logical metadata reserve gives a described budget of 10,652 additional bytes.

Temporary buffers are separate from these items. The unfused prefill prototype in particular shows a memory peak above that of the persistent state alone.

Transition compute

8.2

The protected transition is computed in closed form. It does not need a solver loop run to convergence at every token.

With eight commitments, the algebraic model supplied and reproduced estimates an extra 15,500 additions or multiplications per token, relative to its native comparator.

The review identified omitted operations and differences in the CUDA code counter. This figure is therefore an estimate of the algebraic circuit, not a complete certified hardware count.

8.3Segment-wise formulation

With a fixed register, the affine dependence on \(X\) allows a block formulation. The version studied uses segments of 64 tokens.

The sequential and segment-wise formulations are equivalent in exact arithmetic under the intended conditions. Their floating-point gaps depend in particular on the order of reductions.

Microbenchmarks were run on an RTX 2050. Some of the timed runs, however, did not actually renew commitments. The corresponding ratios do not allow conclusions on the full cost of an active admission and expiration cycle in Sovra vNext.

Equivalence in exact arithmetic between sequential recurrence and affine composition within a 64-token segment with a fixed register.
Segment-wise computation over 64 tokensOpen full size ↗
9

Results of the adversarial review

The technical review, separate from the construction, confirms that the factorisation, the projection of writes and the native reader realise the announced principle in exact arithmetic.

It also identifies several reservations about the frozen version.

9.1 Admission precision

On 512 new geometric states, six CPU admissions and nine GPU admissions exceed the acquisition threshold in FP32.

The maximum GPU value observed is \(0.015635001\), against an acquisition limit of \(0.015625\). The retention limit of 0.03125 is still met in these cases.

The diagnosis traces a leak of the complement into a new protected direction during its numerical reconstruction. The value stored in the pin respects its margin, but that is not enough to bound the final physical read.

This result refutes a universal admission guarantee for the floating-point implementation examined. It does not refute the conservation identity in exact arithmetic.

9.2 Interface and scope of measurements

a GPU conversion to the disabled mode that depends on inactive slots, which could contaminate the state if they hold non-finite values;
the three out-of-domain gates identified in the generator;
omissions in the CUDA code operation count;
performance runs that do not cover the active events announced.
Verdict of the review: principle confirmed, implementation and validation to be corrected.

Interpretation and scope of the results

The results support three conclusions.

01Geometric invariantProtecting selected reads can be formulated as an invariant of the native memory, without freezing the whole bank.
02Explicit transitionThe construction provides an explicit transition, compatible with a compact representation and segment-wise computation.
03Sustained retentionThe campaigns show sustained retention across varied regimes, and reveal the need to evaluate the physical matrix and boundary precision errors.

The functional scope remains that of an associative memory with bounded commitments. The experiments do not yet demonstrate better reasoning, fewer document re-reads or a lower cost for a complete agent.

An integrated evaluation will need to link the vector properties to task measures: effective use of the protected information, respect of constraints, preservation of intermediate results, retrieval frequency and total cost.

Conclusion

NC01 studies temporary consolidation directly within the recurrent memory. The CP64 v2 implementation relies on a component realising the pinned reads, an evolving orthogonal complement and a compensated closed-form transition.

Under the assumptions of the construction, updates preserve the protected reads in exact arithmetic. Protections take effect only on future computations and can expire without erasing the physical matrix.

The simulations and independent checks provide evidence in favour of the mechanism. The numerical counter-examples specify the corrections needed in its floating-point implementation.

References

Published work this article builds on.